Intelligence artificielle
Caractéristiques générales d’une IA
Capacités cognitives
Les capacités cognitives d’une IA peuvent être classées en plusieurs catégories.
Apprentissage
C’est la capacité à améliorer ses performances à partir de données.
L’apprentissage peut être supervisé. Dans ce cas, les données d’entrainement sont étiquetées par des humains. On va labeliser une grande quantité d’images en indiquant ce qu’elles représentent (ex : « chien », « chat », « voiture »). L’IA va ensuite apprendre à reconnaître ces objets dans de nouvelles images.
L’apprentissage peut aussi être non supervisé, où l’IA doit trouver des structures ou des motifs dans les données sans étiquettes. Par exemple, elle peut regrouper des clients en segments de marché basés sur leurs comportements d’achat.
Enfin, il existe l’apprentissage par renforcement, où l’IA apprend à prendre des décisions en interagissant avec un environnement et en recevant des récompenses ou des pénalités.
Raisonnement
C’est la capacité à enchaîner des logiques pour résoudre des problèmes (ex : déduction, induction). Par exemple, une IA peut planifier un itinéraire optimal en fonction du trafic et des conditions météorologiques.
Compréhension du langage
L’IA doit ingérer les bases de connaissances humaines, le plus souvent exprimées sous forme de textes. Elle doit donc effectuer un traitement du langage naturel (NLP) pour comprendre le sens des données. Cela inclut la compréhension de la syntaxe, de la sémantique et du contexte des phrases. Les techniques de NLP utilisées ont fortement évolué ces dernières années, notamment avec l’avènement des modèles de langage de grande taille (LLM) qui permettent une compréhension plus profonde et plus nuancée du langage humain.
Perception
Le texte n’est pas le seul moyen d’encoder les connaissances. L’IA doit aussi être capable de percevoir le monde à travers des capteurs, comme des caméras ou des microphones et effectuer une analyse de ces données sensorielles. Cela inclut la reconnaissance d’images, la détection de sons, et l’interprétation de signaux provenant de divers capteurs.
Mémoire
La mémoire est fondamentale pour le compréhension du contexte et la continuité des interactions. Elle peut être de deux types
La mémoire à court terme : elle permet à l’IA de se souvenir du contexte immédiat d’une conversation ou d’une tâche en cours. Par exemple, si un utilisateur pose une question et que l’IA répond, elle doit se souvenir de cette interaction pour fournir des réponses cohérentes par la suite.
La mémoire à long terme : elle permet à l’IA de stocker des connaissances et des expériences sur une période prolongée. Cela inclut la capacité à apprendre de nouvelles informations, à se souvenir de faits historiques, et à améliorer ses performances au fil du temps et à retrouver rapidement des informations pertinentes lorsqu’elles sont nécessaires.
Pour celà l’information est stockée sous forme de vecteurs (embeddings) de très grandes dimensions, dans des bases de données vectorielles optimisées pour la recherche rapide et efficace. Ces vecteurs permettent à l’IA de retrouver des informations pertinentes en fonction du contexte et des requêtes de l’utilisateur.
Adaptabilité
L’adaptabilité est la capacité d’ajustement à de nouvelles situations ou données sans reconfiguration complète.
L’apprentissage supervisé utilise des données
L’apprentissage non supervisé permet à l’IA de trouver des structures sans labels prédéfinis.
L’apprentissage utilise des récompenses et des pénalités
Le raisonnement en IA inclut la et l’induction.
La mémoire à court terme permet à l’IA de se souvenir du contexte immédiat.
La mémoire à long terme permet de stocker des connaissances sur une période
- L’information en mémoire est stockée sous forme de appelés embeddings
Ces vecteurs sont stockés dans des bases de données optimisées pour la recherche rapide
L’adaptabilité permet à l’IA de s’ajuster à de nouvelles situations.
La compréhension du langage naturel (NLP) est essentielle pour ingérer les bases de connaissances et pour comprendre le sens des données
L’IA doit percevoir le monde à travers des capteurs comme les caméras, les microphones et le texte
Capacités opérationnelles
Les capacités opérationnelles sont les mécanismes qui permettent à l’IA de fonctionner efficacement pour assurer les objectifs décrits ci dessus.
Autonomie
L’autonomie est la capacité à prendre des décisions sans intervention humaine. Elle peut être graduée en demandant des interventions humaines de validation à certains moments.
Interaction
L’interaction est la couche de communication entre l’IA et son environnement, y compris les utilisateurs humains. Cela inclut la capacité à comprendre et à générer du langage naturel, ainsi que la capacité à interagir avec d’autres systèmes via des API ou des interfaces utilisateur. On peut utiliser cette capacité pour refuser de répondre à certaines questions, ou pour demander des clarifications avant de fournir une réponse. C’est la valeur ajoutée de ChatGPT par rapport au LLM sur lequel il est basé.
Explicabilité
L’explicabilité est la capacité à rendre les décisions et les processus de l’IA compréhensibles pour les utilisateurs humains. Cela inclut la capacité à fournir des explications sur les décisions prises, les facteurs qui ont influencé ces décisions, et les données utilisées pour arriver à ces conclusions. L’explicabilité est cruciale pour instaurer la confiance et la transparence dans les systèmes d’IA, en particulier dans des domaines sensibles comme la santé, la finance, ou le droit.
Robustesse
La robustesse est la capacité à résister aux erreurs, aux biais, ou aux attaques. Cela inclut la capacité à maintenir des performances fiables même en présence de données bruitées, de perturbations dans l’environnement, ou d’attaques adversariales visant à tromper le système d’IA. La robustesse est essentielle pour garantir la sécurité et la fiabilité des systèmes d’IA dans des applications critiques.
L’autonomie d’une IA peut être graduée avec des validations humaines.
L’interaction est la couche de communication entre l’IA et son environnement.
L’explicabilité est cruciale pour instaurer la et la transparence.
La valeur ajoutée de ChatGPT par rapport au LLM est principalement l”
La robustesse d’une IA lui permet de résister aux erreurs, aux biais et
L’explicabilité est particulièrement importante dans des domaines sensibles comme la santé.
Limites et contraintes
Le développement et l’utilisation de l’IA s’accompagnent de contraintes importantes dont les plus importantes sont :
biais : il s’agit d’éviter la reproduction de stéréotypes ou de préjugés présents dans les données d’entraînement qui peuvent ne pas refléter les évolutions sociétales ou les valeurs propres à l’organisation de chacune des sociétés humaines (égalité, diversité, inclusion, solidarité, etc.). ;
éthique : respect des cadres légaux et moraux (RGPD, alignement avec les valeurs des sociétes, etc.) ;
ressources : besoin en calcul (GPU/TPU), en ressources naturelles et en données de qualité.
Le principal défi du développement d’IA est d’éviter les
Les biais proviennent de stéréotypes présents dans les données d’entraînement.
L’éthique en IA inclut le respect des cadres légaux comme le RGPD.
Le est un type de ressource critique pour l’IA.
L’IA a besoin de données de pour fonctionner correctement.
Rôle du développeur avec l’IA
On peut voir l’IA générative comme un prestataire extrêmement rapide, peu coûteux, disponible 24h/24, mais dont la qualité n’est pas garantie. Dans cette vision, le rôle du développeur ou de l’ingénieur évolue vers celui d’un maître d’œuvre qui pilote, vérifie et intègre les contributions produites par l’IA.
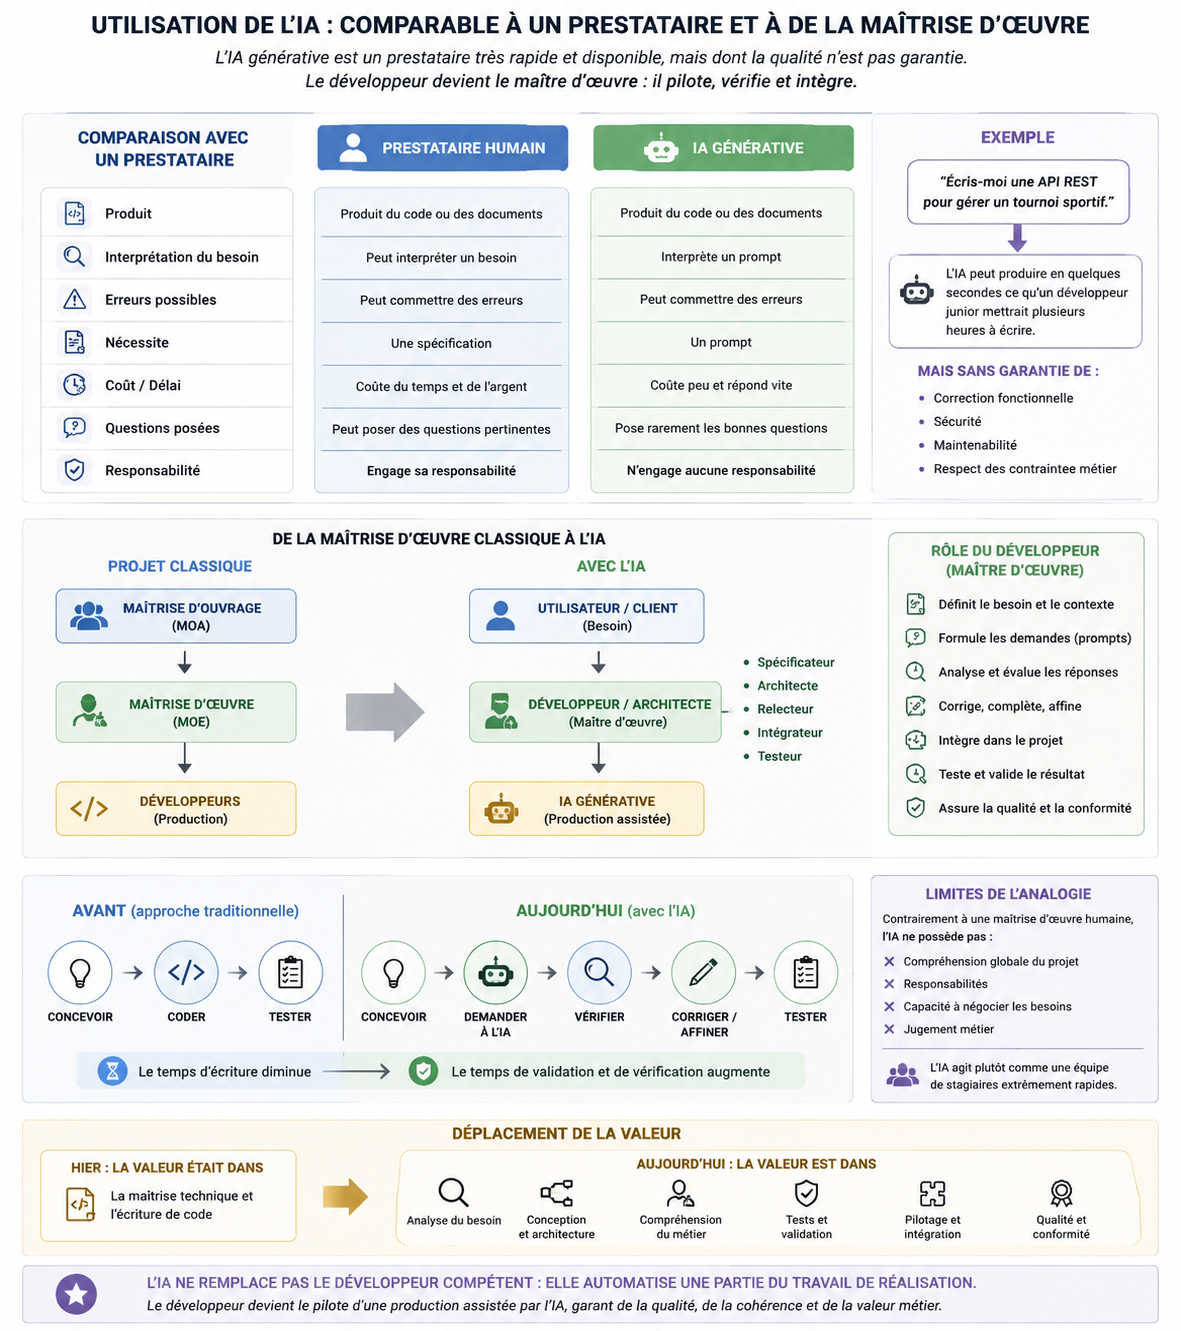
L’IA ne remplace pas vraiment le développeur compétent. Elle tend surtout à automatiser une partie du travail de réalisation, comme le ferait une équipe de sous-traitants qu’il faut coordonner et contrôler.
L’IA générative est disponible 24h/24 et peu coûteuse.
La qualité du code généré par l’IA est garantie.
Le rôle du développeur évolue vers celui d’un
Le développeur doit vérifier et intégrer les contributions produites par l’IA.
L’IA générative fonctionne comme une équipe .
L’IA remplace complètement un développeur compétent.
Le rôle principal du développeur face à l’IA générative est:quiz:{« type »: »SC », « values »: »Laisser l’IA fonctionner seule,Remplacer l’IA,Piloter, vérifier et intégrer les contributions,Augmenter les paramètres », »answer »: »Piloter, vérifier et intégrer les contributions »}
Les LLM
Les LLM (Large Language Models) sont des modèles d’IA spécialisés dans le traitement du langage naturel. Ils sont entraînés sur de vastes corpus de textes pour comprendre et générer du langage humain de manière cohérente et contextuelle.
Architecture
Leur architecture repose sur des réseaux de neurones profonds, basés sur des transformers implémentant des mécanismes d’attention, ce qui permet de capturer les relations complexes entre les mots et les phrases.
Un mécanisme d’attention permet au modèle de se concentrer dynamiquement sur les parties pertinentes du texte d’entrée lorsqu’il génère des réponses, améliorant ainsi la qualité et la pertinence des sorties. Plutôt que de traiter toutes les informations de manière uniforme, le modèle évalue l’importance de chaque élément en fonction du contexte, y compris si ces éléments sont distants dans la séquence.
Un transformer est une architecture de réseau de neurones qui traite les séquences de données (comme le texte) pour capturer les dépendances à long terme entre les éléments de la séquence. Leur introduction a été une rupture majeure dans le domaine du traitement du langage naturel, permettant de surpasser les limitations des architectures précédentes.
Un transformer est composé de deux parties principales : l’encodeur et le décodeur. L’encodeur transforme les entrées en représentations internes, tandis que le décodeur génère les sorties à partir de ces représentations.
La représentation interne est souvent appelée embedding. Il s’agit d’une représentation vectorielle dense des mots ou des phrases, capturant les relations sémantiques et contextuelles entre eux. Ces embeddings sont utilisés pour effectuer diverses tâches de traitement du langage naturel, telles que la traduction automatique, la génération de texte, et la classification de texte.
Les LLM reposent sur une architecture de réseaux de neurones profonds.
Un est l’architecture principale des LLM modernes.
Le mécanisme d’attention applique le même poids à tous les tokens.
Le mécanisme d” permet au modèle de se concentrer sur les parties pertinentes.
Un transformer est composé de l’encodeur et du
Un est une représentation vectorielle dense des mots ou phrases.
Un LLM est
Les LLM reposent sur une architecture de réseaux de neurones profonds appelée
L’architecture a surpassé les limitations précédentes en NLP en capturant les dépendances à long terme entre les éléments de la séquence
Dimensionnement
Les LLM sont caractérisés par le nombre de paramètres qu’ils contiennent, la dimension des embeddings, la taille du contexte, la taille du vocabulaire.
Le nombre de paramètres est un indicateur de la complexité et de la capacité d’apprentissage du modèle. Les LLM modernes peuvent contenir des milliards de paramètres, ce qui leur permet de capturer des nuances linguistiques et contextuelles complexes. C’est le nombre de poids dans le réseau de neurones qui sont ajustés pendant l’entraînement pour minimiser l’erreur de prédiction.
La dimension des embeddings détermine la taille des vecteurs utilisés pour représenter les mots ou les phrases. Des embeddings de plus grande dimension peuvent capturer des relations sémantiques plus riches, mais nécessitent également plus de ressources de calcul et de mémoire.
La taille du contexte fait référence à la quantité d’informations que le modèle peut prendre en compte lors de la génération de texte. Un contexte plus large permet au modèle de mieux comprendre les relations entre les différentes parties du texte, mais peut également augmenter la complexité computationnelle.
La taille du vocabulaire correspond au nombre de mots ou de tokens que le modèle peut reconnaître et traiter. Un vocabulaire plus large permet au modèle de comprendre et de générer un langage plus diversifié, mais peut également augmenter la complexité du modèle.
Voilà une comparaison de quelques LLM populaires :
GPT-4 : 1 T paramètres (?), contexte de 32k tokens ;
Claude Opus 4.8 : 1 T paramètres, contexte de 1M tokens ;
Mistral Medium 3.5 : 128 B paramètres, contexte de 256k tokens.
Le nombre de paramètres est le seul facteur déterminant la performance.
La des embeddings détermine la taille des vecteurs.
Une des embeddings plus grande capture plus de relations sémantiques.
La taille du fait référence à la quantité d’informations traitées.
La taille du correspond au nombre de tokens reconnaissables.
Quel est le contexte de Claude Opus 4.8 ?
Quel LLM a environ 128 B paramètres ?
Structure d’un prompt
Le prompt est la requête que l’on fait à un LLM pour obtenir une réponse. Il doit être structuré de manière à fournir toutes les informations nécessaires pour que le modèle comprenne le contexte et les attentes. Dans le cas de la production de code, il est important de fournir des spécifications claires et détaillées pour guider le modèle dans la génération du code souhaité.
Voici les familles de spécifications que l’on peut inclure dans un prompt pour générer du code. Seuls les 4 premières sont obligatoires, les autres sont optionnelles mais fortement recommandées pour obtenir un code de qualité.
Contexte et objectifs
Pourquoi ce code existe ?
Décrivez l’objectif global du code (implémenter un algorithme de tri pour optimiser une base de données).
Mentionnez l’environnement d’exécution (code destiné à un microcontrôleur ARM avec 16 Ko de RAM).
Précisez les contraintes externes (doit être compatible avec Python 3.8+ et utiliser uniquement la bibliothèque standard).
Exemple
Écris un module Python pour gérer une file d’attente prioritaire (priority queue) utilisée dans un système de tâches planifiées. Le code doit fonctionner sous Python 3.10+ et ne pas dépendre de bibliothèques externes.
Spécifications fonctionnelles
Fonctions/Classes à implémenter
Listez les noms, signatures et rôles de chaque fonction/classe.
Précisez les entrées/sorties (types, formats, exemples).
Ajoutez les cas particuliers (gérer les valeurs None en entrée).
Exemple
Implémente les fonctions suivantes :
enqueue(task: dict, priority: int) -> None: Ajoute une tâche à la file avec une priorité.dequeue() -> dict: Retire et retourne la tâche de plus haute priorité. Lève IndexError si la file est vide.peek() -> dict: Retourne la tâche de plus haute priorité sans la retirer.
Structures de données
Quelles structures utiliser ?
Précisez les types de données (utiliser un
heap(tas) pour la file prioritaire).Décrivez les relations entre les données (les tâches sont des dictionnaires avec les clés
id,nameetpriority).Mentionnez les optimisations attendues (privilégier un
heappour une extraction en O(1)).
Exemple
- Utilise un
heap(via le moduleheapqde Python) pour stocker les tâches. Chaque tâche est un dictionnaire avec : id(int) : Identifiant unique.name(str) : Nom de la tâche.priority(int) : Priorité (0 = haute, 10 = basse). »*
- Utilise un
Préconditions et postconditions
Pour chaque fonction, précisez les préconditions (état avant exécution) et les postconditions (état après exécution).
Exemple
- Préconditions :
prioritydoit être un entier dans[0, 10].taskdoit être un dictionnaire non vide.
- Postconditions :
dequeue()retourne la tâche avec la priorité minimale.La file est vide après
Nappels àdequeue()(oùNest le nombre initial de tâches). »*
Sémantique des variables
Clarifiez le rôle de chaque variable
Exemple
self.heap: Liste utilisée pour stocker les tâches dans un format compatible avecheapq.self.next_id: Compteur pour générer des identifiants uniques pour chaque tâche, incrémenté à chaque appel deenqueue().
Style et conventions
Nommage : Utilise
snake_casepour les fonctions etCamelCasepour les classes.Commentaires : Ajoute des docstrings au format Google pour chaque fonction.
Gestion des erreurs : Lève
ValueErrorsipriorityn’est pas dans[0, 10].Typage : Ajoute des annotations de type (type hints) pour toutes les fonctions.
Exemple
- Respecte les conventions suivantes :
Noms de variables/fonctions en
snake_case.Docstrings au format Google
Utilise
typingpour toutes les variables et fonctions.
Tests et validation
Fournir des exemples de tests pour guider l’implémentation :
Exemple
Test 1 :
enqueue({'id': 1, 'name': 'A'}, 5)puisdequeue()doit retourner{'id': 1, 'name': 'A'}.Test 2 :
dequeue()sur une file vide doit leverIndexError.
Dépendances et environnement
Si nécessaire, préciser :
les bibliothèques autorisées : Utilise uniquement heapq pour le heap.
les contraintes matérielles : Le code doit tourner sur un Raspberry Pi avec 512 Mo de RAM.
les contraintes de compatibilité : Doit être compatible avec Python 3.8+ et Windows/Linux.
Optimisations et bonnes pratiques
Si des optimisations sont attendues, précisez-les clairement :
Complexité algorithmique : la fonction
dequeue()doit avoir une complexité de O(log n).Mémoire : évite les copies inutiles de données.
Documentation attendue
Si le code doit être documenté, précisez les attentes :
ajoute un fichier
README.mdexpliquant comment utiliser le module.inclure des exemples d’utilisation dans les docstrings.
Le premier élément d’un prompt est :
Les spécifications doivent rester volontairement vagues.
Les de données précisent les types à utiliser.
Les définissent l’état avant l’exécution.
Les définissent l’état après l’exécution.
Les tests doivent inclure des exemples d’entrée/sortie.
Le style et les conventions incluent le nommage (snake_case vs CamelCase).
Le dernier élément recommandé pour affiner un prompt est
Les optimisations attendues doivent spécifier la complexité algorithmique requise
Exemple
Voici un exemple de prompt complet pour générer un module de file d’attente prioritaire en Python.
Contexte :
Écris un module Python pour gérer une file d’attente prioritaire (priority queue) utilisée dans un système de tâches planifiées. Le code doit fonctionner sous Python 3.10+, utiliser uniquement la bibliothèque standard, et être optimisé pour des opérations fréquentes (enqueue/dequeue).
Fonctions à implémenter :
PriorityQueue(): Constructeur initialisant une file vide.enqueue(task: Dict[str, Any], priority: int) -> None: Ajoute une tâche avec une priorité (0 = haute, 10 = basse).dequeue() -> Dict[str, Any]: Retire et retourne la tâche de plus haute priorité. LèveIndexErrorsi vide.peek() -> Dict[str, Any]: Retourne la tâche de plus haute priorité sans la retirer.is_empty() -> bool: RetourneTruesi la file est vide.
Structures de données :
Utilise un
heap(viaheapq) pour stocker les tâches.Chaque tâche est un dictionnaire avec les clés
id(int),name(str), etpriority(int).
Préconditions/Postconditions :
Précondition :
priority∈ [0, 10].Postcondition :
dequeue()retourne toujours la tâche avec la priorité la plus basse (valeur numérique la plus petite).
Sémantique :
self.heap: Liste représentant le tas binaire (utilisée parheapq).self.next_id: Compteur pour générer des identifiants uniques (incrémenté à chaqueenqueue).
Style :
Noms en
snake_case, docstrings au format Google, type hints obligatoires.Lève
ValueErrorsipriorityn’est pas dans [0, 10].
Tests :
Inclure quelques validations élémentaires
if __name__ == "__main__":

    q = PriorityQueue()
    q.enqueue({'name': 'Task A'}, 5)
    q.enqueue({'name': 'Task B'}, 2)
    assert q.dequeue() == {'id': 2, 'name': 'Task B', 'priority': 2}
    assert q.is_empty() == False
Optimisations :
enqueueetdequeuedoivent avoir une complexité de O(log n).Évite les copies inutiles de données.
Conseils supplémentaires
Soyez précis : évitez les formulations vagues comme « fais un bon code ». Préférez « optimise pour une latence < 10 ms ».
Donnez des exemples : un exemple d’entrée/sortie vaut mieux qu’une longue description.
Priorisez : commencez par les éléments les plus critiques (ex: préconditions > optimisations).
Itérez : si le code généré ne convient pas, affinez le prompt en ajoutant des contraintes.
Testez : validez le code généré avec des tests unitaires pour vous assurer qu’il répond aux spécifications.
Revue de code avec l’IA
Au cours de cet enseignement, il vous sera demandé d’utiliser l’IA pour faire une revue de votre code. Voici un exemple de prompt que vous pouvez utiliser.
Tu es un professeur d’informatique et tu dois réaliser une évaluation du code que j’ai produit. Ton objectif n’est pas de corriger ou de réécrire le code, mais de m’aider à identifier les problèmes éventuels et à réfléchir à la qualité de ma solution.
Voici l’énoncé du problème :
[ÉNONCÉ]
Voici mon code :
[CODE]
Commence par vérifier que mon programme respecte les exigences de l’énoncé. Identifie ensuite les éventuels bugs, cas limites non traités et erreurs de logique.
Analyse également la lisibilité, la structure, la maintenabilité et, lorsque c’est pertinent, la complexité algorithmique de mon code.
Pour chaque problème identifié, indique :
où il se trouve ;
pourquoi il pose problème ;
dans quelles circonstances il peut se produire ;
comment je pourrais le corriger.
Distingue clairement :
les erreurs qui rendent mon programme incorrect ;
les problèmes importants de conception ou de qualité ;
les améliorations possibles ;
les simples préférences de style.
Ne considère pas comme une erreur une solution différente de celle que tu aurais personnellement proposée si elle respecte correctement l’énoncé.
Ne réécris pas mon code et ne donne pas directement la solution. Je veux d’abord comprendre les problèmes et trouver moi-même les corrections.
Pour les bugs potentiels, donne si possible un exemple concret permettant de reproduire le problème.
Analyse également mes tests s’il y en a et indique quels cas importants ou cas limites ne sont pas suffisamment testés. Propose des idées de tests supplémentaires sans donner directement leur implémentation.
S’il n’y en a pas propose quelques idées de tests pertinents à ajouter.
À la fin, donne-moi :
les trois problèmes les plus importants à corriger ;
les trois améliorations les plus utiles ;
les points positifs de mon travail.
Si tu n’identifies aucun problème important, indique-le clairement plutôt que de chercher artificiellement des défauts.
Documentation
Au cours de cet enseignement, il vous sera demandé d’utiliser l’IA pour documenter votre code. Voici un exemple de prompt que vous pouvez utiliser.
Tu es un professeur d’informatique et tu dois documenter mon code.
Voici l’énoncé du problème :
[ÉNONCÉ]
Voici mon code :
[CODE]
Documente mon code en respectant les règles suivantes :
Ne modifie pas la logique du programme.
N’ajoute pas de fonctionnalités.
N’invente pas de comportement qui n’est pas présent dans le code.
La documentation doit expliquer le code à un autre étudiant ou développeur qui découvre le projet.
Utilise un vocabulaire adapté au niveau du projet.
Évite les commentaires qui décrivent simplement ce que fait chaque ligne.
Privilégie l’explication du pourquoi plutôt que la répétition du comment.
Documente en priorité les parties qui nécessitent une compréhension particulière : algorithmes, choix de conception, traitements complexes, cas particuliers et contraintes.
Ne documente pas les éléments dont le fonctionnement est évident.
Signale les parties du code dont le comportement est difficile à comprendre plutôt que d’inventer une explication.
Pour les fonctions et méthodes, indique lorsque c’est pertinent :
leur rôle ;
leurs paramètres ;
leur valeur de retour ;
les éventuelles exceptions ;
les préconditions ou contraintes importantes.
Pour les algorithmes non triviaux, explique brièvement leur principe et, si pertinent, leur complexité en temps et en mémoire.
Utilise le format de documentation adapté au langage utilisé dans mon code.
Retourne :
le code complet avec la documentation ajoutée ;
une courte liste des principales parties que tu as documentées et la raison pour laquelle elles méritaient de l’être.
Ne change aucun comportement du programme.