Structures de données en C
Dans le chapitre Structures de données, on a abordé les principales structures de données que l’on rencontre en programmation. Quelques exemples ont été générés avec l’aide de l’intelligence artificielle dans les langages C et Python. Dans ce chapitre, nous allons aborder plus en détail les spécificités du langage C et les conséquences que ça a sur leur implémentation.
En fait le langage C possède très peu de structures de données natives comparé à Python. En réalité, le langage fournit surtout des types de base et des tableaux. Les autres structures sont construites par le programmeur à partir de ces éléments.
C utilise des types primitifs. Ce sont les briques élémentaires de la programmation. Ils ont été abordés dans le chapitre Comparaison des langages. On peut citer :
char
int
double
Le langage C possède peu de structures de données natives comparé à Python.
Le tableau est la principale structure de données native en C.
Python et C gèrent la mémoire dynamique de manière identique.
En C, les structures de données complexes doivent être par le programmeur.
Quels types primitifs peut-on utiliser en C ?
Les tableaux
Le tableau est la principale structure de données native en C. Il est très proche de la list en Python. Il permet de stocker une collection d’éléments du même type. On peut donc avoir un tableau d’entiers, un tableau de rééls, un tableau de caractères, etc. Le tableau présente les caractéristiques suivantes :
taille fixe ;
données homogènes ;
mémoire contiguë : manipulation des tableaux avec des pointeurs ;
accès en O(1).
Un tableau en C a une taille fixe définie à la compilation.
Un tableau en C peut contenir des éléments hétérogènes (de types différents).
Les éléments d’un tableau C sont stockés de manière contiguë en mémoire.
L’accès à un élément d’un tableau C est en temps
Un tableau contient une collection d’éléments obligatoirement du type.
Déclaration
En C, comme toute variable, un tableau doit être déclaré avec la syntaxe type nom [ taille ];. Ainsi :
int x[10];déclare un tableauxpermettant de stocker 10 entiers ;double y[10];déclare un tableauypermettant de stocker 10 rééls ;char z[10];déclare un tableauzpermettant de stocker une chaîne de 10 caractères ;int* p[10];déclare un tableauppermettant de stocker 10 pointeurs vers des entiers.
La déclaration définit un espace réservé qui doit être plus vaste que l’espace rééllement utilisé.
Il y a ici une différence majeure entre C et Python :
Python fait croitre/décroitre dynamiquement (au cours de l’exécution du programme) et automatiquement (sans intervention du programmeur) la taille des listes ;
en C la déclaration est statique (définie à la compilation) et la mémoire allouée de cette façon ne peut pas être modifiée au cours de l’exécution du programme. On verra dans le paragraphe Allocation dynamique comment gérer la mémoire dynamiquement (c’est à dire au cours de la vie du programme). Mais contrairement à Python, ça nécessitera l’intervention du programmeur.
La syntaxe
int x[10];réserve de la place pour 10 entiers.La taille d’un tableau doit être une constante à la compilation.
est la déclaration d’un tableau de 10 pointeurs vers des entiers ?
En C, l’espace réservé doit être l’espace réellement utilisé.
peut modifier dynamiquement la taille d’une liste
Initialisation
Dans certains langages, la déclaration d’un tableau initialise également les valeurs à 0. Ce n’est pas le cas en C. Ainsi, le programme suivant, qui déclare un tableau (ligne 5) mais ne l’initialise pas, conduit à un résultat imprévisible (et non reproductible) :
 1//tab.c
 2
 3#include <stdio.h>
 4
 5int main()
 6{
 7    int x[10] ;
 8
 9    // ABSENCE d'INITIALISATION
10
11    for ( int i = 0; i < 10; i++ ){
12        printf("%d\n", x[i]);
13    }
14
15    return 0;
16}
Lorsqu’on l’exécute dans un terminal, on obtient des valeurs étranges:
-1409518872 32573 -2096975408 22037 0 0 -2096975744 22037 898055648 32766
A la déclaration, le compilateur réserve 40 octets (4 octets pour chacun des 10 éléments du tableau) quelque part dans la mémoire. L’affichage reflète l’état de cette portion de mémoire.
Encore plus ennuyeux, l’affichage d’un élément qui n’appartient pas au tableau est un code C valide (en Python ça déclenche une erreur) :
printf("%d ", x[10]);
Dans le meilleur des cas, une autre valeur étrange est retournée. Dans le pire des cas, cet accès illégal peut provoquer le crash du programme
Segmentation fault
Il est donc indispensable de :
déclarer le tableau pour réserver de la place en mémoire ;
initialiser ses valeurs, sinon ce sont des nombres aléatoires ;
et contrôler l’accès aux éléments d’un tableau, sinon on risque un accès à une zone illégale de la mémoire et un crash du programme.
En C, la déclaration d’un tableau initialise automatiquement les valeurs à 0.
Un tableau non initialisé contient des valeurs aléatoires.
Accéder à un indice hors limites d’un tableau peut causer une segmentation fault.
Une segmentation fault est causée par à la mémoire.
contrôle automatiquement les accès hors limites ?
Pour les tableaux de taille réduite, on peut déclarer/initialiser en une seule instruction. La taille du tableau n’est pas requise, elle est déduite de la partie RHS (Right Hand Side) de l’affectation :
int x[] = {0, 1, 2, 3, 4, 5, 6, 7, 8, 9} ;
On peut également (d’abord) déclarer, puis (ensuite) initialiser le tableau dans une autre partie du programme :
int x[10] ;

for ( int i = 0; i < 10; i++ ){
        x[i] = i ;
        printf("%d ", x[i]);
    }
Avertissement
La déclaration/initialisation globale dans une même instruction est correcte :
int x[10] = {0, 1, 2, 3, 4, 5, 6, 7, 8, 9} ;
La déclaration, suivie de l’initialisation élément par élément est correcte également :
int x[10];

for (int i=0 ; i<10 ; i++) {
    x[i] = i;
}
Mais la déclaration, suivie d’une initialisation globale échoue à la compilation :
int x[10];
x = {0, 1, 2, 3, 4, 5, 6, 7, 8, 9};
Le compilateur renvoie une erreur de compilation car hors déclaration, l’accolade est utilisée pour délimiter un bloc de code.
error: expected expression before '{' token
x = {0, 1, 2, 3, 4, 5, 6, 7, 8, 9};
Tableau multidimensionnel
Le langage C permet la manipulation de tableaux multi dimensionnels avec la syntaxe
type nom [ x ][ y ];
qui déclare un tableau de x lignes et y colonnes.
Voici deux façons de déclarer / initialiser un tableau à 2 dimensions. La première fait apparaître explicitement la structuration en lignes et en colonnes :
int x[2][3] = {
{0, 1, 2} ,
{3, 4, 5}
};
La seconde non. Le tableau est rempli de gauche à droite et de haut en bas (ligne par ligne) :
int x[2][3] = {0, 1, 2, 3, 4, 5};
Chacune des deux déclaration / initialisation conduit au même résultat :
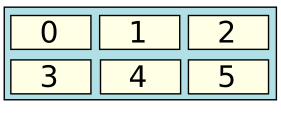
L’accès à un des éléments est direct : x[1][2] = 5.
Un tableau multidimensionnel utilise plusieurs paires de crochets.
La syntaxe
int x[2][3]déclare un tableau de 2 lignes et 3 colonnes.Combien d’éléments peut contenir un tableau
int x[2][3]?Un tableau multidimensionnel est rempli de et de haut en bas.
Il est nécessaire que VS Code soit démarré sur la machine hôte, pointe vers le répertoire e3-programmation-labs-student et que le container Docker soit lancé.
Le répertoire concerné est lab_c_tableau_statique. Lisez attentivement le fichier README.md pour comprendre la consigne. Il est efficace d’y accéder depuis le dépôt distant pour profiter du formatage.
Une fois l’exercice terminé, assurez vous que les repos local et distant soient correctement synchronisés.
Manipulation avec des pointeurs
Un tableau est une zone réservée de la mémoire, possédant les caractéristiques suivantes :
une adresse de début ;
un type d’élément qui détermine la taille mémoire de chaque élément ;
une taille totale(en nombre d’éléments). La taille est définie lors de la déclaration du tableau et ne peut pas être modifiée par la suite.
Avertissement
Contrairement à Python, hors de la fonction déclarante, un tableau C ne connait ni le nombre de ses éléments, ni sa taille. Il y a plusieurs conséquences :
on doit impérativement passer la taille du tableau en paramètre des fonctions manipulant les tableaux ;
en général,on ne peut pas déterminer la taille d’un tableau en utilisant la syntaxe
sizeof(t)/sizeof(t[0]). Ceci ne fonctionne que dans la fonction déclarante.
Puisqu’un tableau est caractérisé par l’adresse de son premier élément, il est donc naturel d’imaginer manipuler un tableau avec des pointeurs. On va même voir que ça donne une grande flexibilité.
Considérons le programme suivant qui initialise un tableau avec les premières valeurs de la suite de Fibonacci.
 1// tab2.c
 2
 3#include <stdio.h>
 4
 5#define SIZE 20
 6
 7int main()
 8{
 9
10    // Déclaration
11
12    int x[100];
13    // int* p = x;
14
15    // Initialisation
16
17    x[0] = 1;
18    x[1] = 1;
19    for (int i = 2; i < SIZE; i++)
20        x[i] = x[i - 1] + x[i - 2];
21}
On peut afficher les valeurs de façon traditionnelle, avec la syntaxe x[i] :
1for (int i = 0; i < 10; i++)
2    printf("x[%d] = %d\n",i, x[i]);
Le résultat est sans surprise:
x[0] = 1
x[1] = 1
x[2] = 2
x[3] = 3
x[4] = 5
x[5] = 8
x[6] = 13
x[7] = 21
x[8] = 34
x[9] = 55
Observons le code suivant qui affiche respectivement le tableau sous forme de pointeur, l’adresse de la variable déclarée comme tableau, et l’adresse du premier élément du tableau:
printf("  x   = %p\n", x);
printf(" &x   = %p\n", &x);
printf("&x[0] = %p\n", &x[0]);
Le résultat peut sembler étonnant au premier abord, puisque les 3 valeurs sont identiques:
  x   = 0x7fffe5322070
 &x   = 0x7fffe5322070
&x[0] = 0x7fffe5322070
Cela signifie que :
le nom de la variable qui désigne un tableau est en fait… un pointeur ;
ce pointeur représente l’adresse du tableau global ;
et ce n’est rien d’autre que l’adresse de son premier élément.
L’équivalence tableau - pointeur est donc naturelle parce que pour le langage C ces deux notions se confondent !
On peut tirer profit de cette équivalence pour manipuler différemment les éléments d’un tableau. Puisque x est un pointeur vers le début du tableau :
x+iest un pointeur vers la ième case du tableau ;et
*(x+i)est le contenu de la ième case du tableau.
Note
Si x est un pointeur, dans l’expression x+1, 1 ne représente pas un entier mais la taille d’un élément du tableau ! C’est ce qu’on appelle l’arithmétique des pointeurs. Ainsi x+1 décalera l’adresse x de :
4octets si c’est un tableau d’entiers ;8octets si c’est un tableau de doubles ;1octet si c’est un tableau de char ;
Ainsi, puisque la syntaxe *(x+i) est strictement équivalente à x[i], le code ci dessous :
for (int i = 0; i < 10; i++)
    printf("*(x+%d) = %d\n",i ,*(x+i) );
produit le même résultat que précédemment.
Puisque l’on manipule des pointeurs, on peut observer l’occupation mémoire avec l’opérateur & :
for (int i = 0; i < 10; i++)
    printf("&x[%d] = %p\n",i , x+i );
Le résultat de l’exécution:
&x[0] = 0x7fffe5322070
&x[1] = 0x7fffe5322074
&x[2] = 0x7fffe5322078
&x[3] = 0x7fffe532207c
&x[4] = 0x7fffe5322080
&x[5] = 0x7fffe5322084
&x[6] = 0x7fffe5322088
&x[7] = 0x7fffe532208c
&x[8] = 0x7fffe5322090
&x[9] = 0x7fffe5322094
Tout ceci est résumé dans le graphique suivant.
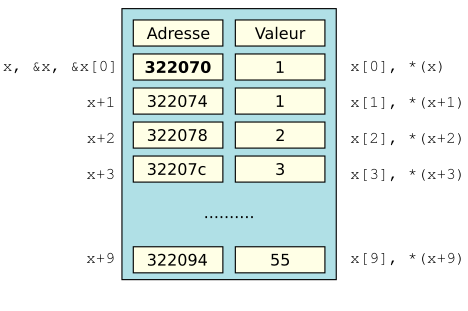
Quel est le type des éléments du tableau
x?Le plan d’adressage est cohérent avec le type.
Les cases mémoires réservées pour chaque élément du tableau sont contigües.
Un programmeur étourdi a réalisé le même programme en utilisant un tableau de doubles pour stocker les éléments de la suite de Fibonacci. Inférer le résultat de l’exécution précédente en faisant l’hypothèse que l’adresse de départ est la même.
Quel est l’écart entre deux cases mémoire consécutives ?
Quel est le gaspillage mémoire (en octets) sur un tableau de 100 cases ?
Il est nécessaire que VS Code soit démarré sur la machine hôte, pointe vers le répertoire e3-programmation-labs-student et que le container Docker soit lancé.
Le répertoire concerné est lab_c_tableau_statique_pointeurs. Lisez attentivement le fichier README.md pour comprendre la consigne. Il est efficace d’y accéder depuis le dépôt distant pour profiter du formatage.
Une fois l’exercice terminé, assurez vous que les repos local et distant soient correctement synchronisés.
Les chaines de caractères
Pour manipuler les chaines de caractères, Python possède un type str. Un caractère unique est un cas particulier d’un objet de type str de longueur 1.
A contrario le langage C dispose du type primitif char pour manipuler les caractères uniques, et la chaîne de caractères est traitée comme un tableau de n char terminé par \0.
On retrouve là les deux caractéristiques des deux langages :
Python est un langage haut niveau et manipule la chaine de caractère ;
C est un langage bas niveau et manipule le caractère.
Une chaîne de caractères en C est un tableau de
char.Une chaîne en C est terminée par le caractère
\0.Python et C traitent les chaînes de la même manière.
Une chaîne de
ncaractères utilisera octets en mémoire.est le type primitif en C pour manipuler un caractère unique.
Déclaration
La chaine de caractères étant un tableau de caractères, la déclaration peut donc se faire de façon similaire à ce qu’on a vu pour les tableaux :
char s[14] = {'H', 'e', 'l', 'l', 'o', ' ', 'W', 'o', 'r', 'l', 'd', ' ', '!', '\0'};
On lui préfèrera cependant une façon plus compacte, où la taille sera déduite de la partie RHS de la déclaration (comme déjà vu dans le chapitre sur les tableaux) et la chaine définie par une suite de caractères délimitée par des guillemets " :
char s[] = "Hello World !";
Pour cette deuxième façon d’initialiser la chaine de caractères, le caractère terminal \0 (nécessaire pour identifier la fin) est inséré automatiquement à la fin. Corollaire : une chaine de n caractères utilisera n+1 octets en mémoire.
Une chaîne peut être initialisée avec des guillemets, par exemple
"Hello".Le caractère
\0marque la fin d’une chaîne en C.\0est automatiquement ajouté à la fin d’une chaîne initialisée avec des guillemets.Une chaîne de 5 caractères occupera octets en mémoire.
déduit la taille d’une chaîne déclarée avec
char s[] = "hello"?
A expérimenter
On considère le programme suivant :
 1// str.c
 2
 3#include <stdio.h>
 4
 5int main()
 6{
 7    char s[] = "Hello World !";
 8
 9    for (int i=0 ; s[i]!='\0' ; i++)
10        printf("i = %2d, s[%2d] = %c, &s[%2d] = %p\n", i, i, s[i], i, &s[i]);
11
12return 0;
13}
Répondez aux questions suivantes :
avant de l’exécuter, uniquement en l’examinant, que fait-il ?
prêter une attention particulière à l’écriture de la condition de continuation (ligne 9). Quelle propriété des chaines de caractères met elle en oeuvre ?
après exécution du programme, et observation des adresses mémoire, peut on retrouver la taille allouée à une variable de type
char?pourquoi le caractère terminal
\0n’est il pas affiché ?
Affichage
L’expérimentation précédente met en oeuvre un affichage caractère par caractère, utile pour la compréhension mais sans intérêt pour l’affichage dans le terminal. La fonction printf() dispose de l’espace réservé %s pour l’affichage des chaines :
Le code
printf("%s\n", s);
produit dans le terminal:
Hello World !
On peut parcourir une chaîne jusqu’à
\0dans une boucle.affiche une chaîne complète
affiche un seul caractère
Manipulation avec des pointeurs
Puisqu’une chaine de caractères est un tableau, on peut également la manipuler avec un pointeur. En particulier, si s est déclarée comme une chaine de caractères, les trois instructions ci dessous sont équivalentes et affichent l’adresse mémoire du premier caractère de la chaîne.
printf("%p\n", s);
printf("%p\n", &s);
printf("%p\n", &s[0]);
On peut également se servir de l’arithmétique des pointeurs pour l’affichage caractère par caractère :
char *p = s;

while(*p != '\0') {
        printf("%c", *p);
        p++;
}
Note
On pourrait aussi penser à utiliser un pointeur pour déclarer la chaine :
char* p = "Hello World !";
Mais cette façon de faire devra toutefois être évitée car dans ce cas la modification n’est pas une opération sûre. Interroger l’IA pour savoir pourquoi.
Il est préférable de déclarer la chaine avec un tableau de caractères, puis un pointeur pour la parcourir :
char s[] = "Hello World !";
char *p = s;

while(*p != '\0') {
    printf("%c", *p);
    p++;
}
Tableau de chaines
Une chaine de caractères étant déjà un tableau de caractères, un tableau de chaines de caractères sera donc implémenté sous la forme d’un tableau dee pointeurs vers des chaines de caractères. Le code ci dessous illustre cette approche :
 1// arrayofstrings.c
 2
 3#include <stdio.h>
 4
 5const int SIZE = 5;
 6
 7int main()
 8{
 9
10    char *simpsons[] = {
11        "Homer",
12        "Marge",
13        "Bart",
14        "Lisa",
15        "Maggie"};
16
17    char *p;
18
19    for (int i = 0; i < SIZE; i++)
20    {
21        p = simpsons[i];
22
23        while (*p != '\0')
24        {
25            printf("%c", *p);
26            p++;
27        }
28
29        printf("\n");
30    }
31}
Le code ci dessus présente deux particularités :
Un tableau de chaînes est un tableau de pointeurs vers des chaînes.
Un tableau de chaînes stocke directement les caractères.
La syntaxe
char *simpsons[]déclare unest le type de chaque élément de
char *simpsons[]
l’utilisation d’une constante (ligne 5). Dans tout le code
SIZEsera remplacée par le compilateur par la valeur5;- le double parcours du tableau à deux dimensions :
on accède à chaque chaine de caractères par son pointeur stocké dans le tableau
simpsons(ligne 19) ;chaque chaine est parcourue par ce pointeur incrémenté jusqu’à ce qu’il atteigne le caractère terminal (ligne 23).
L’exécution donne le résultat attendu
$ gcc -Wall -Wextra arrayofstrings.c -o arrayofstrings
$ ./arrayofstrings
Homer
Marge
Bart
Lisa
Maggie
$
Lecture du clavier
Jusqu’à présent les données utilisées étaient stockées « en dur » dans le code source. Ca nous a permis de mettre en évidence les principes élémentaires du langage C mais il y aurait évidemment une plus grande souplesse à pouvoir lire quelques informations directement au clavier, durant l’exécution du programme.
La fonction fgets() permet ceci :
 1#include <stdio.h>
 2#include <string.h>
 3
 4int main(){
 5    char s[100];
 6
 7    printf("Entrez une chaine de caractères : %s\n", s);
 8    fgets(s, 100, stdin);
 9    printf("La chaine de caractères récupérée dans s : %s\n", s);
10    printf("composée de %ld caractères lus au clavier\n", strlen(s));
11}
A la ligne 8, la fonction fgets() prend en paramètres :
la chaine dans laquelle les caractères saisis au clavier seront stockés (elle est déclarée ligne 5) ;
le nombre maximal de caractères à lire ;
et le périphérique utilisé.
stdinreprésente le clavier mais on pourrait tout aussi bien lire les données dans un fichier.
La fonction
fgetslit des caractères au clavier.Le paramètre
stdinreprésente l’entrée standard (clavier).fgetsinclut automatiquement la nouvelle ligne\ndans la chaîne.La fonction calcule la longueur d’une chaîne.
Quelle fonction lit une chaîne entière de manière sûre ?
Lorsqu’on exécute ce programme:
$ gcc -std=c99 -Wall -Wextra read-keyboard.c -o read-keyboard
$ ./read-keyboard
Entrez une chaine de caractères :
hello
La chaine de caractères récupérée dans s : hello

composée de 6 caractères lus au clavier
$
Pour cette exécution, l’utilisateur a rentré au clavier la chaine hello et validé la saisie avec Enter.
Observer l’affichage dans le terminal et notamment :
le saut de ligne. D’où provient il ?
le nombre de caractères stockés dans la chaine
s. Est il en accord avec la chaine entrée au clavier ? D’où provient l’écart ?
Il est nécessaire que VS Code soit démarré sur la machine hôte, pointe vers le répertoire e3-programmation-labs-student et que le container Docker soit lancé.
Créer un fichier exercices/affichage-caractere-position.c qui contient une fonction principale main() qui affiche chaque caractère d’une chaîne lue au clavier sur une ligne séparée en ajoutant l’information de position. Le résultat devrait être similaire à
$ ./affichage-caractere-position
Entrez une chaine de caractères :
hello
La chaine de caractères récupérée dans s : hello

composée de 6 caractères lus au clavier
Caractère  0 : h
Caractère  1 : e
Caractère  2 : l
Caractère  3 : l
Caractère  4 : o
Caractère  5 :
Vérifier le bon fonctionnement du programme. Une fois qu’il est opérationnel, synchroniser les repos :
git add .
git commit -m "Affichage caractère et position en C"
git push
Il est nécessaire que VS Code soit démarré sur la machine hôte, pointe vers le répertoire e3-programmation-labs-student et que le container Docker soit lancé.
Il est courant que les données entrées au clavier soient numériques, sous forme d’entiers ou de nombres rééls. La fonction fgets() stocke la saisie au clavier dans une chaine de caractères. Il faut donc une opération de conversion de type. Celle ci est réalisée en C avec les fonctions suivantes, dont le prototype est défini dans <stdlib.h> :
atoi()pour la conversion vers un entier ;atod()pour la conversion vers un double.
Créer un fichier exercices/conversion-numerique.c qui contient une fonction principale main() qui lit une chaine numérique au clavier et affiche le résultat de sa multiplication par 2. Le résultat devrait être similaire à
$ ./conversion-numerique
Entrez une chaine de caractères :
123456
après multiplication par 2 : 246912
Vérifier le bon fonctionnement du programme. Une fois qu’il est opérationnel, synchroniser les repos :
git add .
git commit -m "Conversion numérique en C"
git push
Passage des arguments en ligne de commande
Lire le clavier c’est bien, mais passer directement les arguments sur la ligne de commande, c’est mieux !
Jusqu’à présent, l’appel de la fonction main() se faisait sans aucun argument. Et donc la ligne de commande déclenchant l’exécution du programme ne comportait qu’un seul élément.
Par exemple:
$ ./conversion-numerique
Mais le langage C permet de récupérer les caractères saisis sur la même ligne, pour les utiliser comme données d’entrée. Pour cela, il faut utiliser les deux paramètres optionnels (dont on s’est passé jusqu’à présent) pour appeler la fonction main() :
int main( int argc, char *argv[] )
Ici :
argcest un entier qui représente le nombre total d’arguments sur la ligne de commande, y compris le nom du programme exécutable ;et
*argv[]un tableau de pointeurs vers les chaines de caractères dans lesquelles ont été stockés les arguments.
argcinclut le nom du programme dans le compte.argvest un tableau de pointeurs vers des chaînes.argv[0]contient le premier argument passé par l’utilisateur.argv[0]contient lesont les paramètres permettant d’accéder aux arguments en ligne de commande ?
Un exemple d’utilisation :
// cmdline.c

#include <stdio.h>

int main(int argc, char *argv[])
{
    for (int i=0; i < argc ; i++)
    {
        printf("argument %d : %s\n", i, argv[i]);
    }
    return 0;
}
Lorsqu’on exécute ce programme:
$ ./cmdline james bond 007
argument 0 : ./cmdline
argument 1 : james
argument 2 : bond
argument 3 : 007
Structures et alias
Les tableaux permettent de manipuler une collection d’éléments homogènes, soit directement, soit, c’est préférable voire indispensable, à l’aide de pointeurs. Pour manipuler une collection d’éléments inhomogènes, le langage C introduit la notion de structure que l’on définit avec le mot clé struct.
Les structures permettent de stocker des données hétérogènes.
Une structure est définie avec le mot clé
struct.Les structures peuvent contenir des éléments de types différents.
Les structures permettent de manipuler une collection d’éléments
Un premier exemple
Imaginons que l’on souhaite concevoir un programme de gestion d’une librairie pour lequel chaque livre serait défini par les informations suivantes :
titre ;
nom de l’auteur ;
numéro ISBN ;
prix.
Voyons comment implémenter ces données.
Déclaration de la structure
Pour stocker cette information, on peut créer une structure Book de la façon suivante:
struct Book
{
    char title[100];
    char author[50];
    long int isbn;
    double price;
};
Chaque information correspond à un champ de la structure et lors de la compilation la mémoire sera réservée conformément au type et à la taille de chacun de ces champs. Dans le cas présent, elle réserve 2 tableaux de char pour le titre et l’auteur, un long int pour le numéro ISBN et un double pour le prix.
Pour savoir à quel endroit déclarer cette structure, rappelons les bonnes pratiques de l’organisation d’un programme C. Le code source se décompose en 4 parties:
Les directives
includeetdefine;les variables globales ;
les fonctions secondaires ;
la fonction principale
main().
Dans le code source, la structure sera donc placée avant les fonctions secondaires, dans l’espace des variables globales. Comme elle est définie en dehors des fonctions, elle sera donc accessible par chacune de ces fonctions.
Une structure réserve de la mémoire pour tous ses champs.
Une structure doit être déclarée avant sa première utilisation.
Une structure doit être placée dans l’espace des variables globales.
Note
Le long int est ici nécessaire car le simple int ne permet pas de stocker de très grands nombre. Or le numéro ISBN peut comporter jusqu’à 13 chiffres.
Observons les valeurs limites de chacun des deux types, en prêtant attention à l’emplacement réservé pour l’affichage d’un long int. Cette opération nécessite le fichier limits.h:
//limit.c

#include <stdio.h>
#include <limits.h>

int main( ) {


printf( "Valeur max pour un int      : %d\n", INT_MAX);
printf( "Valeur max pour un long int : %ld\n", LONG_MAX);

return 0;
}
Le résultat de l’exécution
$ gcc -std=c99 -Wall -Wextra limit.c -o limit
$ ./limit
Valeur max pour un int      : 2147483647
Valeur max pour un long int : 9223372036854775807
Une fois la structure déclarée, l’étape suivante est de l’initialiser, puis de l’afficher.
Initialisation et affichage
Ecrivons une fonction main() permettant de manipuler cette structure. L’accès aux champs de la structure se fait avec l’opérateur . :
On accède aux champs d’une structure avec l’opérateur
.Une variable de type
struct Bookpeut stocker plusieurs informations.Les champs d’une structure partagent la même zone mémoire.
Pour accéder au champ
titled’une structurebook, on utiliseest l’opérateur qui accède aux champs d’une variable de structure
int main()
{
    struct Book book1 = {"Le Seigneur des anneaux", "J.R.R. Tolkien", 2266286269, 18.90};

    printf("Book title : %s\n", book1.title);
    printf("Book author : %s\n", book1.author);
    printf("Book ISBN : %li\n", book1.isbn);
    printf("Book price : %.2f €\n", book1.price);

    return 0;
}
Remarquer le modificateur .2 utilisé pour l’affichage du prix. Il sert à ne conserver que deux chiffres décimaux lors de l’affichage. C’est sans incidence sur sa représentation en mémoire qui continue à utiliser la pleine résolution.
Astuce
On peut évaluer la place occupée en mémoire par une instance de la structure Book à partir de la taille de chacun de ses champs. Ce n’est qu’une évaluation car le compilateur peut réserver de la mémoire supplémentaire (padding) pour des raisons d’alignement. La mémoire est adressée par blocs de 4 octets pour une plus grande efficacité. Ce mécanisme s’appelle l’alignement mémoire.
Pour vérifier cette hypothèse, on peut utiliser l’opérateur sizeof et le modificateur de format %zu.
printf("size of Book structure: %zu bytes\n", sizeof(myBook));
printf("    size of title field: %zu bytes\n", sizeof(myBook.title));
printf("    size of author field: %zu bytes\n", sizeof(myBook.author));
printf("    size of ISBN field: %zu bytes\n", sizeof(myBook.isbn));
printf("    size of price field: %zu bytes\n", sizeof(myBook.price));
Utiliser les résultats ci dessus pour répondre au quizz
char title[100]occupe octets en mémoirechar author[50]occupe octets en mémoireun
long intoccupe octets en mémoireun
doubleoccupe octets en mémoirela structure
Bookréserve octets en mémoire pour chaque enregistrementla structure
Bookoccupe plus de mémoire que strictement nécessaireil y a octets réservés et non utilisés par le champ
Structures et fonctions
Une structure est un type de variable au même titre qu’un int, un double, un char, un tableau ou un pointeur. Avec une fonction, on peut donc théoriquement utiliser les structures comme :
argument de la fonction ;
ou valeur de retour de la fonction.
Note
Cependant on se souvient que les arguments sont passés à une fonction par copie de valeurs. Comme pour les tableaux, il est donc extrêmement couteux de passer la structure elle même en argument et il sera préférable d’utiliser plutôt des pointeurs pour localiser celle ci dans la mémoire. Ce point sera abordé dans le prochain paragraphe.
Pour illustrer l’utilisation d’une structure comme argument, écrivons la fonction printBook() qui :
prend en argument une structure de type
Book;affiche les champs de la structure ;
et ne retourne rien.
1void printBook(struct Book book)
2{
3    printf("Book title : %s\n", book.title);
4    printf("Book author : %s\n", book.author);
5    printf("Book ISBN : %li\n", book.isbn);
6    printf("Book price : %.2f\n", book.price);
7}
Remarquez la construction structure.champ utilisée. Lorsqu’on manipule directement une structure, l’accès aux champs de cette structure s’obtient avec l’opérateur ..
Son appel, depuis la fonction main() est immédiat :
1int main()
2{
3    struct Book book1 = {"Le Seigneur des anneaux", "J.R.R. Tolkien", 2266286269, 18.90};
4    printBook(book1);
5    return 0;
6}
L’exemple ci dessus montre l’utilisation d’une structure comme argument d’une fonction.
On préfèrera cependant utiliser un pointeur vers la structure plutôt que la structure elle même pour économiser de la mémoire.
Pointeur vers une structure
Comme pour les autres types, on peut définir un pointeur vers une structure avec l’opérateur *.
Structure en lecture seule
Afin de ne pas gaspiller de mémoire par recopie de valeurs, ré écrivons la fonction printBook() pour qu’elle prenne en argument un pointeur vers une structure Book plutôt que la structure elle même :
void printBook(struct Book *book)
{
    printf("Book title : %s\n", book->title);
    printf("Book author : %s\n", book->author);
    printf("Book ISBN : %li\n", book->isbn);
    printf("Book price : %.2f\n", book->price);
}
L’accès aux champ d’une structure manipulée avec un pointeur utilise l’opérateur ->. Ainsi, la construction book->title est une écriture abrégée, équivalente à (*book).title.
Modification d’une structure
La fonction printBook() ci dessus utilise la structure en lecture. Elle ne modifie aucun champ de celle ci. Mais comme un pointeur vers la structure à modifier est passé en argument, on peut également manipuler la structure en écriture, en la modifiant.
Ecrivons une fonction changePrice() qui:
prend en argument un pointeur vers une structure
Booket un pourcentage décimal entre 0 et 100% ;modifie le prix conformément au pourcentage ;
et ne retourne rien.
Les consignes ci dessus permettent d’écrire la signature de la fonction. Le code est trivial :
void changePrice(struct Book *book, double percent){
    book->price *= 1+percent/100;
}
La fonction est appelée dans main() de la façon suivante :
struct Book book2 = {"Game Of Thrones, Le trône de fer", "George R.R. Martin", 2290208876, 22.0};
printBook(&book2);
changePrice(&book2, -5);
printBook(&book2);
Avant l’appel:
Book title : Game Of Thrones, Le trône de fer
Book author : George R.R. Martin
Book ISBN : 2290208876
Book price : 22.00
Après l’appel de changePrice():
Book title : Game Of Thrones, Le trône de fer
Book author : George R.R. Martin
Book ISBN : 2290208876
Book price : 19.80
Le prix a bien été diminué de 5%.
Exercice
Utiliser les fragments de code ci dessus pour construire le programme exécutable produisant l’affichage suivant:
$ gcc -std=c99 -Wall -Wextra book.c -o book
$ ./book
Book title : Le Seigneur des anneaux
Book author : J.R.R. Tolkien
Book ISBN : 2266286269
Book price : 18.90
Book title : Game Of Thrones, Le trône de fer
Book author : George R.R. Martin
Book ISBN : 2290208876
Book price : 22.00
Baisse de prix !
Book title : Game Of Thrones, Le trône de fer
Book author : George R.R. Martin
Book ISBN : 2290208876
Book price : 20.90
Définition de type
Le code ci dessus est fonctionnel mais présente quelques lourdeurs dans la déclaration des structures qui nécessite deux mots clés :
structpour indiquer à C que le type qui va suivre est une structure ;et le nom de la structure proprement dite.
On peut définir un type personnalisé (on dit aussi un alias) avec le mot clé typedef qui est suivi de deux arguments :
le type pour lequel on veut créer un alias ;
suivi du nom de l’alias.
Note
Si l’utilisation de typedef est illustrée dans ce qui va suivre avec une structure, ça fonctionne de manière similaire pour tous les types avec la syntaxe:
typedef type alias;
Un alias s’utilise de la façon suivante. On en profite pour manipuler les deux premiers champs comme des pointeurs char* et non plus comme des tableaux de char.
typedef struct Book
    {
        char *title;
        char *author;
        long int isbn;
        double price;
    } Book;
Ce code suivant indique au compilateur C que chaque fois que l’on rencontrera Book il faudra le remplacer par struct Book {...}. Et donc :
une déclaration
struct Book booksera remplacée par :une déclaration
Book book.
On a modifié deux champs de la structure. Qu’en est il maintenant de la taille de celle ci ?
char *titleoccupe octets en mémoirechar *authoroccupe octets en mémoireun
long intoccupe octets en mémoireun
doubleoccupe octets en mémoirela structure
Bookréserve donc octets en mémoire pour chaque enregistrement
Cependant La taille est bien inférieure à celle de la première version, celle avec les tableaux de char. Quelle en est la raison ?
les chaines de caractères ont été compressées ;
les chaines de caractères sont stockées en dehors de la structure elle même.
Pour connaitre la longueur d’une chaine de caractère, on peut faire appel à la fonction strlen(), dont le prototype est déclaré dans <string.h>. Une version simplifiée:
int strlen(char *str);
Utiliser strlen() pour connaitre la taille du champ title et author des livres de Tolkien et Martin.
Le champ
titledu livre Le Seigneur des anneaux occupe octets en mémoireLe champ
authordu livre Le Seigneur des anneaux occupe octets en mémoireLe champ
titledu livre Game Of Thrones occupe octets en mémoireLe champ
authordu livre Game Of Thrones occupe octets en mémoire
Le programme peut ainsi être ré écrit comme ci dessous :
// book2.c

#include <stdio.h>

typedef struct Book
{
    char *title;
    char *author;
    long int isbn;
    double price;
} Book;

void printBook(Book *book)
{
    printf("Book title : %s\n", book->title);
    printf("Book author : %s\n", book->author);
    printf("Book ISBN : %li\n", book->isbn);
    printf("Book price : %.2f\n", book->price);
}

int main()
{
    Book book1 = {"Le Seigneur des anneaux", "J.R.R. Tolkien", 2266286269, 18.90};
    Book book2 = {"Game Of Thrones, Le trône de fer", "George R.R. Martin", 2290208876, 22.0};

    printBook(&book1);
    printBook(&book2);

    return 0;
}
Tableau de structures
En C on peut manipuler des tableaux :
de types prédéfinis :
int,double,char, etc. ;de pointeurs :
int*,double*,char*, etc. ;mais également de
struct.
Illustrons ça en définissant une collection de Book avec un tableau :
typedef Book Books[50];
L’instruction ci dessus définit Books comme un tableau de 50 Book.
On peut définir une fonction setBookFields() pour renseigner un Book:
void setBookFields(Book* book, char* title, char* author, long int isbn, double price){
    book->title = title;
    book->author = author;
    book->isbn = isbn;
    book->price = price;
}
Quelques questions pour une meilleure compréhension de la fonction :
La variable
bookutilisée dans la fonctionsetBookFields()est de typeBookLa variable
bookutilisée dans la fonctionsetBookFields()est de typeBook*La variable
bookutilisée dans la fonctionsetBookFields()est une structureLa variable
bookutilisée dans la fonctionsetBookFields()est un pointeur
Utilisons là pour remplir quelques éléments du tableau :
int main()
{
    Books books;
    setBookFields(&books[0], "Le Seigneur des anneaux", "J.R.R. Tolkien", 2266286269, 18.90);
    setBookFields(&books[1], "Game Of Thrones, Le trône de fer", "George R.R. Martin", 2290208876, 22.0);
    setBookFields(&books[2], "Le Nom de la rose", "Umberto Eco", 2253033138, 8.90);

    return 0;
}
La variable
booksutilisée dans la fonctionmain()est de typeBooksLa variable
booksutilisée dans la fonctionmain()est de typeBooks*La variable
booksutilisée dans la fonctionmain()est une structureLa variable
booksutilisée dans la fonctionmain()est un pointeurLa variable
booksutilisée dans la fonctionmain()est un tableau
L’opérateur d’indexation [ ] est prioritaire par rapport à l’opérateur d’adressage &, ce qui nous permet d’écrire :
&books[0];plutôt que
&(books[0]), pour une écriture allégée.
Si l’on souhaite afficher la collection, on peut écrire une fonction printBooks() qui fait appel à printBook():
void printBooks(Books *books, int n){
    for (int i=0; i<n; i++){
        printBook(*books+i);
        printf("\n");
    }
}
L’opérateur d’indirection * est prioritaire par rapport à l’opérateur d’addition +, ce qui nous permet d’écrire :
*books+i;plutôt que
(*books)+i, pour une écriture allégée.
Le résultat est tel qu’attendu:
Book title : Le Seigneur des anneaux
Book author : J.R.R. Tolkien
Book ISBN : 2266286269
Book price : 18.90

Book title : Game Of Thrones, Le trône de fer
Book author : George R.R. Martin
Book ISBN : 2290208876
Book price : 22.00

Book title : Le Nom de la rose
Book author : Umberto Eco
Book ISBN : 2253033138
Book price : 8.90
La variable
booksutilisée dans la fonctionprintBooks()est de typeBooksLa variable
booksutilisée dans la fonctionprintBooks()est de typeBooks*La variable
booksutilisée dans la fonctionprintBooks()est une structureLa variable
booksutilisée dans la fonctionprintBooks()est un pointeurLa variable
booksutilisée dans la fonctionprintBooks()est un pointeur vers une structureLa variable
booksutilisée dans la fonctionprintBooks()est un pointeur vers un tableauLa variable
*booksutilisée dans la fonctionprintBooks()est de typeBooksLa variable
*booksutilisée dans la fonctionprintBooks()est de typeBooks*La variable
*booksutilisée dans la fonctionprintBooks()est une structureLa variable
*booksutilisée dans la fonctionprintBooks()est un pointeurLa variable
*booksutilisée dans la fonctionprintBooks()est un tableau
Allocation dynamique
L’exécution d’un programme nécessite l’utilisation de la mémoire vive de la machine. La mémoire peut être décomposée (de façon simplifiée) en plusieurs zones (ou segments) comme le montre la figure ci dessous.
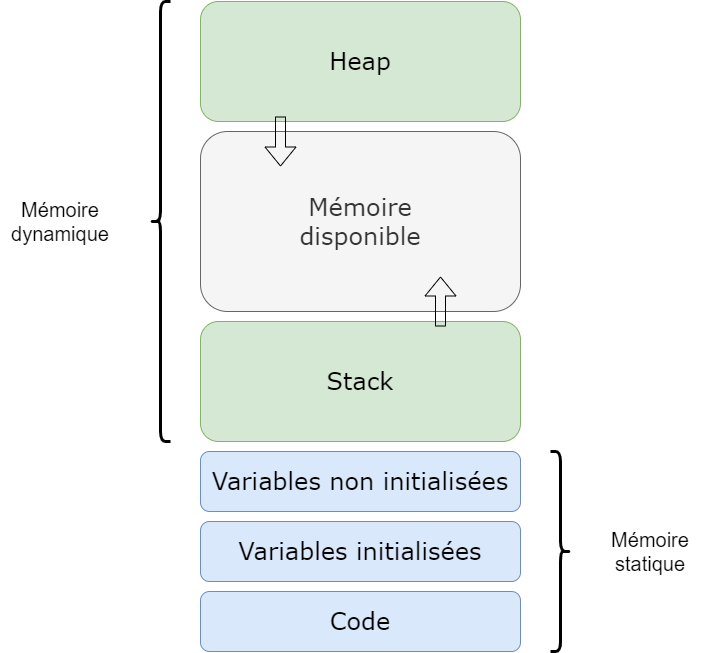
Les zones mémoire utilisées pour manipuler les variables sont :
la stack placée dans les adresses hautes de la mémoire et allouée en progressant vers les adresses basses ;
et le heap placée dans les adresses plus basses de la mémoire et allouée en progressant vers les adresses hautes ;
Les programmes que l’on a écrit jusqu’à présent ont utilisé 2 zones de mémoire :
la mémoire statique, qui contient le code source de notre programme et les variables globales ;
et la stack.
La stack
Jusqu’à présent, la mémoire nécessaire à l’exécution des programmes a été allouée statiquement à la compilation (pour les variables globales), ou automatiquement durant l’exécution du programme, puis libérée à la fin de l’exécution du programme. La mémoire nécessaire était réservée dans une zone appelée la pile ou stack.
La stack est une zone mémoire intéressante pour les raisons suivantes :
elle est gérée par le CPU ;
la réservation de la mémoire est faite automatiquement ;
la mémoire est automatiquement libérée lorsqu’on sort de la fonction.
mais elle a aussi des inconvénients :
le compilateur a besoin de connaître l’encombrement mémoire avant l’exécution du programme. Ceci a généralement pour conséquence de surdimensionner la place réservée ;
la taille est limitée par le système d’exploitation (généralement 8 Mb). On obtient la taille (en Kb) avec
$ ulimit -s
8192
Pour illustrer son fonctionnement, on considère le programme suivant.
#include <stdio.h>

int addOne(int x) {
    return x+1;
}

int main(){
    int x = 3;
    printf("before main(), x = %d\n", x);
    x = addOne(x);
    printf("after main(),  x = %d\n", x);
}
La mémoire est utilisée de la façon suivante :
le code machine est placé dans la partie basse de la mémoire ;
la fonction
addOne()et sa variable localexsont placées dans la stack ;la fonction
main()et sa variable localexsont placées dans la stack ;
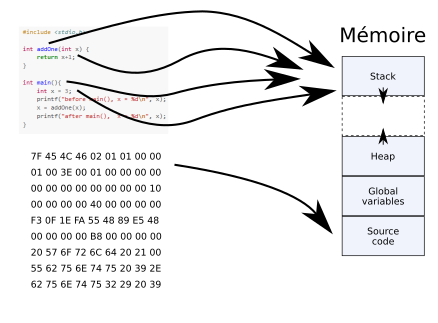
On compile et on exécute
$ gcc -std=c99 -Wall -Wextra addone.c -o addone
$ ./addone
before main(), x = 3
after main(),  x = 4
Le programme utilise séquentiellement la stack de la façon suivante.
a : avant l’exécution la stack est vide ;
b : une zone est réservée lorsque la fonction
main()est lancée. La variable localexy est déclarée et initialisée ;c : une autre zone est réservée lors de l’appel à
addOne(). La variable localexy est déclarée et initialisée ;d : cette zone est libérée après l’instruction
returndeaddOne(). La variable localexest détruite ;e : la stack est totalement libérée après l’instruction
returndemain(). La variable localexest détruite .
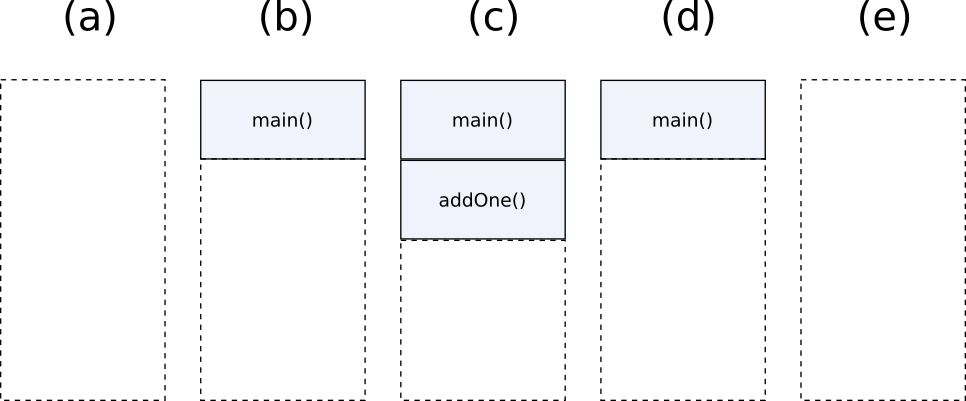
L’étape (d) explique que les variables locales à une fonction secondaire sont détruites lorsque l’on sort de la fonction, et par conséquent ne sont plus accessibles.
Le recours à la stack imposant de fortes contraintes, C permet l’utilisation d’une zone mémoire plus étendue : le tas ou heap.
Le heap
Contrairement à la stack, le heap possède les caractéristiques suivantes:
sa taille n’est pas fixée a priori. Elle n’est limitée que par la taille de la mémoire physique de la machine ;
l’allocation (et la désallocation) doit se faire manuellement ;
les variables doivent être manipulées avec des pointeurs.
Les langages modernes tels que Python gèrent automatiquement l’allocation et la désallocation mémoire, avec un dispositif appelé garbage collector. L’interpréteur contrôle cycliquement l’utilisation de la mémoire et libère les zones qui ne sont plus utilisées.
La gestion manuelle de la mémoire est une des forces, mais également une des difficultés de la programmation en langage C :
on évite le recours au garbage collector de Python qui est (un peu) coûteux en temps de calcul ;
mais il faut toujours penser à libérer la mémoire non utilisé sous peine de fuites mémoire (memory leak) qui affectent tout le système d’exploitation.
L’allocation de mémoire
L’allocation de mémoire est réalisée avec l’une ou l’autre des fonctions suivantes:
malloc()réserve de la mémoire sans initialisation ;calloc()réserve de la mémoire avec initialisation à 0.
Le prototype de chacune de ces deux fonctions est déclaré dans <stdlib.h>. Les prototypes (simplifiés) :
void* malloc( int memorySize );
void* calloc( int elementCount, int elementSize );
Chacune des deux fonctions retourne un type void* qui est un pointeur sur n’importe quel type. Ca fonctionnera donc pour des pointeurs vers des zones mémoire contenant des char, des int, des double, etc.
Les deux fonctions poursuivent le même objectif mais différent dans la façon de dimensionner la mémoire à réserver :
malloc()nécessite en argument la taille totale du bloc mémoire à réserver ;calloc()nécessite en argument le nombre d’éléments et la taille individuelle de chacun des éléments.
Un exemple d’appel pour réserver de la mémoire pour un tableau de 10 entiers avec malloc() :
int *ptr;
ptr = malloc(10 * sizeof(int));
La même opération avec calloc() :
int *ptr;
ptr = calloc(10, sizeof(int));
Si le système d’exploitation dispose de mémoire disponible malloc() et calloc() retournent l’adresse de début du bloc mémoire réservé sous forme de pointeur. S’il n’y a plus de mémoire disponible, chacune des deux fonctions retourne NULL. Il conviendra donc de contrôler le bon déroulement de l’opération de réservation de mémoire en testant la valeur de retour :
if (ptr == NULL)
    {
        printf("Memory allocation failed, exiting...\n");
        exit(-1);
    }
Un premier exemple pour réserver de la mémoire pour un tableau d’entier :
 1// malloc1.c
 2
 3#include <stdio.h>
 4#include <stdlib.h>
 5
 6#define SIZE 5
 7
 8int main()
 9{
10    int *ptr;
11
12    ptr = malloc(SIZE * sizeof(int));
13
14    if (ptr == NULL)
15    {
16        printf("Memory allocation failed, exiting...\n");
17        exit(-1);
18    }
19
20    printf("Memory allocation succeed, continuing...\n");
21
22    // Initialisation
23    for (int i = 0; i < SIZE; i++)
24        *(ptr + i) = rand() % 100;
25
26    // Display
27    for (int i = 0; i < SIZE; i++)
28        printf("%p : %d\n", ptr+i, *(ptr+i));
29
30    return 0;
31}
La compilation et l’exécution de ce programme
$ gcc -std=c99 -Wall -Wextra malloc1.c -o malloc1
$ ./malloc1
Memory allocation succeed, continuing...
0x7fffded032a0 : 83
0x7fffded032a4 : 86
0x7fffded032a8 : 77
0x7fffded032ac : 15
0x7fffded032b0 : 93
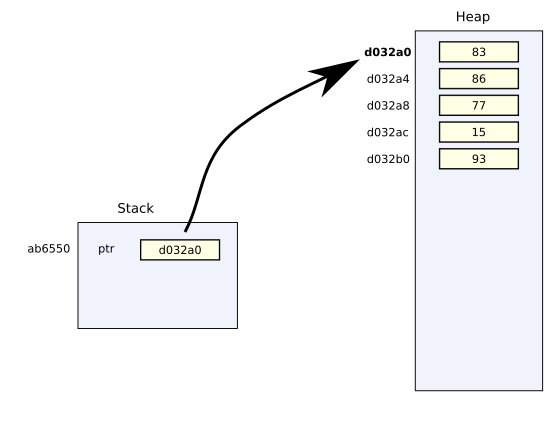
Le bloc mémoire réservé comporte éléments
Le bloc mémoire réservé comporte octets
Le bloc mémoire réservé débute à l’adresse
Le bloc mémoire réservé se termine à l’adresse
Le pointeur ptr a pour valeur
Le pointeur ptr a pour adresse
La valeur du 3ième élément du tableau est
Avec l’opérateur d’indexation, la valeur du 3ième élément du tableau s’obtient avec
Avec l’opérateur d’indirection, la valeur du 3ième élément du tableau s’obtient avec
A expérimenter
Remplacer SIZE sur la ligne 12 par une valeur supérieure à la taille de la mémoire vive de votre machine. Compiler et exécuter. Que se passe t-il ?
Libération de la mémoire
La mémoire réservée avec malloc() ou calloc() n’est pas automatiquement libérée. C’est de la responsabilité du programmeur de le faire. Pour cela on utilise la fonction free() dont le prototype est déclaré dans <stdlib.h>. Le prototype (simplifié) :
void free(void *ptr)
La fonction prend en argument un pointeur de n’importe quel type, libère la mémoire correspondante et ne retourne rien.
L’exemple précédent ne met pas en oeuvre cette opération, ce qui n’est pas une bonne pratique.
A la fin du programme, un programmeur consciencieux aurait écrit :
free(ptr);
L’impact était cependant limité puisque la mémoire est de toutes façons restituée au système d’exploitation lorsque le programme se termine.
Il est nécessaire que VS Code soit démarré sur la machine hôte, pointe vers le répertoire e3-programmation-labs-student et que le container Docker soit lancé.
Le répertoire concerné est lab_c_tableau_dynamique. Lisez attentivement le fichier README.md pour comprendre la consigne. Il est efficace d’y accéder depuis le dépôt distant pour profiter du formatage.
Une fois l’exercice terminé, effectuer une revue de code, ajouter la documentation, et s’assurer que les repos local et distant soient correctement synchronisés.