Structures de données en Python
Dans le chapitre Structures de données, on a abordé les principales structures de données que l’on rencontre en programmation. Quelques exemples ont été générés avec l’aide de l’intelligence artificielle dans les langages C et Python. Dans ce chapitre, nous allons aborder plus en détail les spécificités du langage Python.
On a vu dans le chapitre Structures de données en C que le langage C est un langage de bas niveau qui impose de gérer soi-même la mémoire et les structures de données. Le langage Python, quant à lui, est un langage de haut niveau, qui offre des structures de données intégrées et une gestion automatique de la mémoire.
Nous allons donc nous concentrer sur les structures de données intégrées nativement au langage Python, telles que les listes, les tuples, les ensembles et les dictionnaires. Nous verrons comment les utiliser efficacement pour résoudre des problèmes courants en programmation.
Note
Python est livré avec une bibliothèque standard riche qui fournit de nombreuses fonctionnalités pour travailler avec des structures de données plus complexes. Pour garder une empreinte mémoire raisonnable, ces structures de données complexes ne sont pas chargées em mémoire par défaut. Il est donc nécessaire d’importer les modules correspondants pour les utiliser. On utilise pour cela le mot-clé import.
Les chaines de caractères
Une vidéo de présentation des chaînes de caractères…
Généralités
En Python tout est objet, et donc les chaînes de caractères sont des objets qui peuvent se définir à partir des simples ' ou des double " quotes.
>>> a = "hello"
>>> b = 'hello'
>>> c = "world"
Ici on a créé 3 objets « chaîne de caractères » :a, b et c.
Note
En programmation objet, la création d’un objet fait appel à un constructeur auquel on passe le contenu de l’objet à créer. Ainsi pour créer la chaîne de caractère « hello », on peut faire appel au constructeur de la classe str.
>>> a = str('hello')
>>> a
'hello'
Cependant les caractères " ou ' produisent le même résultat avec une syntaxe plus légère. On appelle ça du sucre syntaxique.
Chaque objet créé possède plusieurs caractéristiques parmi lesquelles :
son contenu ;
son identité, obtenue avec la fonction
id().
On peut tester l’égalité du contenu de deux objets avec l’opérateur ==.
>>> a == b
True
>>> a == c
False
Ici, en plus d’avoir le même contenu, les variables a et b ont la même identité, c’est à dire sont deux références distinctes vers le même objet. On peut le vérifier avec la fonction id(). On peut également vérifier que a et b sont deux références distinctes vers le même objet avec l’opérateur is.
>>> id(a)
37940000
>>> id(b)
37940000
>>> a is b
True
Note
Dans ce cas, lors de la création de b Python a trouvé un objet identique en mémoire et n’a pas éprouvé le besoin d’en créer un second. Il a simplement créé une nouvelle référence vers l’objet déjà référencé par a.
Une curiosité, lorsque la chaîne de caractère est plus longue, deux objets différents sont créés.
>>> a = "hello"*1000 # "hellohellohello...hello" 1000 fois
>>> b = "hello"*1000
>>> a is b
False
En généralisant l’exemple ci dessus, on peut avoir deux références o1 et o2 vers deux objets distincts contenant une même valeur. Dans ce cas :
>>> o1 == o2
True
>>> o1 is o2
False
On peut utiliser les délimiteurs dans la chaîne de caractère elle même, mais il faut les échapper avec \.
>>> s = "J'entends et j'oublie, je vois et je me souviens, je fais et je comprends"
>>> s
"J'entends et j'oublie, je vois et je me souviens, je fais et je comprends"
>>> s = 'J\'entends et j\'oublie, je vois et je me souviens, je fais et je comprends'
>>> s
"J'entends et j'oublie, je vois et je me souviens, je fais et je comprends"
On peut insérer des caractères spéciaux utilisés pour l’affichage: la tabulation \t et le retour à la ligne \n. Ces caractères apparaissent tels quels dans la chaîne de caractères mais sont interprétés correctement à l’affichage.
>>> s = "Veni,\t vidi,\t vici\n"
>>> s
'Veni,\t vidi,\t vici\n'
>>> print(s)
Veni,    vidi,  vici

>>>
Note
Il faut différencier la chaîne de caractère elle même, de sa représentation. Les caractères imprimables (lettres, chiffres, la plupart des caractères spéciaux) sont rendus tels quels, alors que les caractères non imprimables sont transformés par la fonction print() avant affichage. Par exemple \n est transformé en saut de ligne.
Les chaînes multilignes, que l’on a déjà aperçues dans les docstring, utilisent un triple séparateur.
>>> s = """
... Si tu peux voir détruit l'ouvrage de ta vie
... Et sans dire un seul mot te mettre à rebâtir
... Ou perdre en un seul coup le gain de cent parties
... Sans un geste et sans un soupir
... """
>>> s
"Si tu peux voir détruit l'ouvrage de ta vie\nEt sans dire un seul mot te mettre
 à rebâtir\nOu perdre en un seul coup le gain de cent parties\nSans un geste et
sans un soupir\n"
>>> print(s)
Si tu peux voir détruit l'ouvrage de ta vie
Et sans dire un seul mot te mettre à rebâtir
Ou perdre en un seul coup le gain de cent parties
Sans un geste et sans un soupir
Python est un langage permettant la redéfinition des opérateurs, ce qui permet de les adapter au contexte de l’objet. Pour les chaînes de caractères, l’opérateur + a été redéfini comme opérateur de concaténation, et comme on l’a aperçu précédemment, l’opérateur * a également été redéfini.
>>> 'Hello ' + 'world ' + '!'
'Hello world !'
>>> 'Hi '*3
'Hi Hi Hi '
Les chaînes de caractères sont des séquences
Les séquences jouent un grand rôle dans Python. Une séquence est une collection ordonnées d’objets. Pour le cas particulier des chaînes de caractères, il s’agit évidemment d’une collection ordonnée de caractères.
On peut connaitre la longueur d’une séquence avec la fonction len(). Le premier caractère de la chaîne est à l’index 0, le dernier à l’index len(s)-1.
>>> s = "Hello World!"
>>> len(s) # longueur de la chaine
13
>>> s[0] # premier élément de la chaine
'H'
>>> s[len(s)-1] # dernier élément de la chaine
'!'
>>> s[8]
'r'
Python utilise les index négatifs pour utiliser la fin de chaine comme référence, plutôt que le début.
>>> s[-1] # dernier élément de la liste
'!'
>>> s[-3]
'l'
Une façon simple de visualiser ce fonctionnement est de considérer que les index définissent les intervalles plutôt que les éléments eux mêmes.
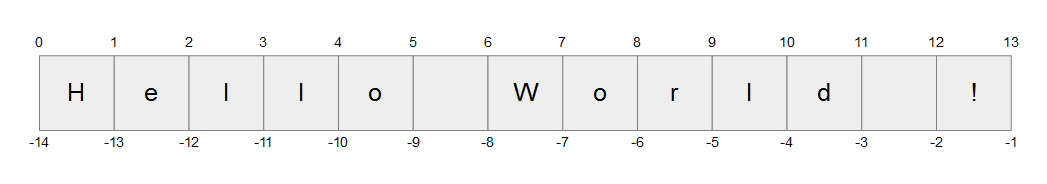
Lorsque l’index est positif, on prend l’élément à droite et lorsque l’index est négatif, on prend l’élément à gauche. Si on essaye d’accéder à un élément qui n’existe pas, une erreur se produit.
>>> s[8]
'r'
>>> s[-6]
'o'
>>> s[14]
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
IndexError: string index out of range
Comme exposé précédemment, la dernière ligne décrit la nature de l’erreur en langage naturel et donne une piste pour la résolution du problème.
Slicing
On peut découper la chaîne de caractère avec la syntaxe s[d:f:p] où :
dreprésente l’index de début ;fl’index de fin ;et
ple pas.
Dans cette syntaxe, le premier index d est inclus, le dernier f ne l’est pas. s[d:f] produit donc la chaîne de caractère composée des éléments s[d] à s[f-1]. On prendra donc tous les éléments à droite de d et à gauche de f.
>>> s[0:3]
'Hel'
Il y a deux avantages majeurs à cette syntaxe, illustrés par les deux propriétés suivantes :
s[:i] + s[i:] = s
f-dest la longueur de la chaîne de caractère
La première rend la chaine simple à découper, à l’image de la relation de Chasles pour les vecteurs.
La seconde fournit une relation simple entre la longueur de la chaine et les index de début et de fin.
Note
Dijkstra (l’inventeur de l’algorithme utilisé dans les GPS) donne une explication détaillée de la pertinence de cette convention dans cet article.
Lorsque l’un des index est omis, il est remplacé par une valeur par défaut, dépendante du contexte (sens du parcours). Le sens du parcours est défini par les index de début d et de fin f.
Pour un parcours de gauche à droite (Left To Right : LTR), pour lequel d ≤ f :
la valeur par défaut de
dest0;la valeur par défaut de
festlen(s)-1;la valeur par défaut de
pest1.
Observons quelques exemples faisant appel aux valeurs par défaut dans un contexte LTR.
>>> s[0:7] # d et f sont explicites. p est implicite
'Hello W'
>>> s[0:9:2]  # d, f et p sont explicites
'HloWr'
>>> s[:7]  # f est explicite. d et p sont implicites
'Hello W'
>>> s[6:] # d est explicite. f et p sont implicites
'World !'
>>> s[::3] # d et f sont implicites. p est explicite
'HlWl!'
A expérimenter…
Chacun des 3 index utilisés pour le slicing peut prendre une valeur explicite ou par défaut. Ce qui donne 8 possibilités. Pour le parcours LTR, 5 sont présentées ci dessus. Identifier les 3 autres cas, les mettre en oeuvre sur un exemple, conjecturer le résultat et vérifier dans l’interpréteur interactif.
Pour un parcours de droite à gauche (Right To Left : RTL), pour lequel f ≤ d :
la valeur par défaut de
destlen(s)-1;la valeur par défaut de
fest0;la valeur par défaut de
pest-1.
Observons quelques exemples faisant appel aux valeurs par défaut dans un contexte RTL.
>>> s[-1:-8:-1] # d, f et p sont explicites
'! dlroW'
>>> s[:-8:-1] # f et p sont explicites. d est implicite
'! dlroW'
>>> s[-9::-1] # d et p sont explicites. f est implicite
'olleH'
>>> s[::-3] # d et f sont implicites. p est explicite
'!lWlH'
A expérimenter…
Chacun des 3 index utilisés pour le slicing peut prendre une valeur explicite ou par défaut. Ce qui donne 8 possibilités. Pour le parcours RTL, 4 sont présentées ci dessus. Identifier les 4 autres cas, les mettre en oeuvre sur un exemple, conjecturer le résultat et vérifier dans l’interpréteur interactif.
Cas particulier : la syntaxe s[::-1] permet de renverser la chaine de caractère en une seule opération:
>>> s = "anticonstitutionnellement"
>>> s[::-1] # la chaîne inversée
'tnemellennoitutitsnocitna'
Les chaînes de caractère sont des séquences immutables ce qui signifie qu’on ne peut pas les modifier. Il faut alors créer une autre chaîne.
>>> s[6] = 'w'
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: 'str' object does not support item assignment
>>> s2 = s[:6] + 'w' + s[7:]
>>> s2
'Hello world !'
Itérer sur une chaîne de caractères
Comme on vient de le voir, en Python les chaînes de caractères sont des séquences. Python dispose d’un opérateur commun à toutes les séquences, que l’on retrouvera par la suite. Il s’agit de l’opérateur in. Il a deux grands rôles majeurs.
Le premier est le test d’appartenance.
>>> s = "anticonstitutionnellement"
>>> 'z' in s
False
>>> 'a' in s
True
Il permet également d’itérer de façon simple sur les chaînes de caractères.
>>> s = "alpha"
>>> for c in s:
...     print(c)
...
a
l
p
h
a
L’opérateur in sera utilisé dans bien d’autres strutures de données, comme on aura l’occasion de le voir par la suite.
Les méthodes de chaîne
Tout est objet en Python et on dispose d’un grand nombre de méthodes de chaines.
Chacune de ces méthodes peut être appelée sur une chaîne de caractères : Quelques exemples…
>>> s = "anticonstitutionnellement"
>>> s.capitalize()
'Anticonstitutionnellement'
>>> s.upper()
'ANTICONSTITUTIONNELLEMENT'
>>> s.find('c')
4
Lorsque l’on doit effectuer une opération sur un objet en général, et sur des chaînes de caractères en particulier, la bonne démarche est de se documenter sur les méthodes disponibles pour l’objet considéré. Si le traitement est complexe et ne peut être réalisé à partir des méthodes fournies par le langage, alors on peut penser à implémenter ses propres fonctions, le plus souvent en se servant des méthodes built-in comme briques de base.
A expérimenter…
Mettre en oeuvre quelques méthodes de chaines de caractères pour se familiariser avec la démarche et manipuler la documentation.
Formatage
Pour un affichage optimal, il est souvent nécessaire de formatter la chaîne de caractères (str). Python dispose d’un mécanisme appelé f-strings qui permet de formater les chaînes de caractères de manière concise et lisible.
Une f-string possède la structure suivante : f"texte {expression} texte". Les accolades {} permettent d’insérer des expressions Python dans la chaîne de caractères. Ces expressions sont évaluées et leur valeur est insérée dans la chaîne de caractères.
Par exemple, pour afficher la valeur de PI avec 3 décimales, on peut utiliser une f-string comme suit :
>>> import math
>>> f"La valeur de PI arrondie : {math.pi:.3f}"
'La valeur de PI arrondie : 3.142'
Ici math.pi est l’expression évaluée, et :.3f est un format spécifiant que la valeur doit être affichée avec 3 décimales.
Pour plus d’informations sur le formatage des chaînes de caractères, on consultera la documentation officielle de Python sur les f-strings.
Ce qu’il faut retenir
Une chaine de caractère peut se délimiter avec
'Une chaine de caractère peut se délimiter avec
"Une chaine de caractère peut se délimiter avec
"""Une chaine de caractère délimitée par
'peut inclure des sauts de ligne mais il faut utiliser un caractère spécialUne chaine de caractère délimitée par
"peut inclure des sauts de ligne mais il faut utiliser un caractère spécialUne chaine de caractère délimitée par
"""peut inclure des sauts de ligne mais il faut utiliser un caractère spécialLe test d’égalité utilise l’opérateur
isLe test d’identité utilise l’opérateur
==Pour les opérations de slicing, l’index définit le caractère
Pour les opérations de slicing, l’index définit l’intervalle entre les caractères
Pour les opérations de slicing, les index et le pas peuvent être positifs
Pour les opérations de slicing, les index et le pas peuvent être négatifs
Pour les opérations de slicing, les index et le pas peuvent être nuls
Pour les opérations de slicing, les index et le pas peuvent être implicites
Pour les opérations de slicing, si l’index est positif, on sélectionne le caractère immédiatement à gauche
Pour les opérations de slicing, si l’index est négatif, on sélectionne le caractère immédiatement à droite
Pour les opérations de slicing, si le pas est positif, on parcourt la chaine de gauche à droite (LTR)
Pour les opérations de slicing, si le pas est négatif, on parcourt la chaine de droite à gauche (RTL)
Itérer sur une chaine de caractère impose de manipuler les index
Itérer sur une chaine de caractère impose de manipuler les caractères
La bonne pratique lorsqu’on itère sur une chaine de caractère est de manipuler les caractères
Le formatage d’une chaine de caractère permet de contraindre sa longueur
Il est nécessaire que VS Code soit démarré sur la machine hôte, pointe vers le répertoire e3-programmation-labs-student et que le container Docker soit lancé.
Le répertoire concerné est lab_python_palindromes. Lisez attentivement le fichier README.md pour comprendre la consigne. Il est efficace d’y accéder depuis le dépôt distant pour profiter du formatage.
Une fois l’exercice terminé, effectuer une revue de code, ajouter la documentation, et s’assurer que les repos local et distant soient correctement synchronisés.
Les listes
Une vidéo de présentation d’un premier container, les listes…
Nous avons vu jusqu’à présent deux types d’objets, que l’on peut considérer « atomiques » :
Lorsque l’on veut manipuler un ensemble de ces objets, et même un ensemble d’objets plus complexes, Python dispose de plusieurs containers pour stocker ces objets.
Le plus simple de ces containers est la list qui est une collection ordonnée d’objets (éventuellement hétérogènes) définie avec les opérateurs [ et ].
>>> l = [0, 1, 1, 2, 3, 5, 8, 13, 21, 34]
>>> l
[0, 1, 1, 2, 3, 5, 8, 13, 21, 34]
>>> len(l)
10
Tout est objet en Python et la list n’échappe bien sûr pas à la règle. En tant qu’objet, la list dispose donc de plusieurs méthodes permettant d’effectuer un certain nombre d’opérations courantes sur ce type de structure. Les plus élémentaires sont abordées ci dessous.
Slicing
Comme les chaînes de caractères, une list est une sequence, et à ce titre dispose des mêmes opérations d’indexation et de slicing. Toutes les propriétés décrites dans le paragraphe sur le Slicing des chaines de caractères sont valables.
>>> l[0] # accès au premier élément de la liste
0
>>> l[-1] # accès au dernier élément de la liste
34
>>> l[::2] # les éléments de rang pair
[0, 1, 3, 8, 21]
A expérimenter…
Mettre en oeuvre quelques opérations de slicing un peu plus complexes que celles qui précèdent, conjecturer le résultat et vérifier dans un interpréteur interactif.
Modification des éléments d’une liste
Contrairement aux chaînes de caractères, la list est une séquence mutable. Il est donc possible de modifier ses éléments.
>>> l = [0, 1, 1, 2, 3, 5, 8, 13, 21, 34]
>>> l[0] = 'zéro'
>>> l
['zéro', 1, 1, 2, 3, 5, 8, 13, 21, 34] # liste hétérogène
Modification de la structure d’une liste
On peut également modifier la structure de la liste, en ajoutant ou en retirant des éléments, ce qui va modifier sa longueur.
On peut ajouter des éléments n’importe où dans une list en utilisant la méthode insert() ou les supprimer avec remove().
>>> l.insert(2,99)
>>> l
['zéro', 1, 99, 1, 2, 3, 5, 8, 13, 21, 34]
>>> l.remove(99) # remove(elt) ne retourne rien
>>> l
['zéro', 1, 1, 2, 3, 5, 8, 13, 21, 34]
La méthode pop() permet également de retirer un élément de la liste en passant son index en argument. L’élément retiré est disponible et peut être affecté à une nouvelle variable (référence):
>>> first = l.pop(0) # pop(index) retourne l'élément retiré de la liste
>>> first
'zéro'
>>> l
[1, 1, 2, 3, 5, 8, 13, 21, 34]
L’ajout d’un élément à la fin d’une list est un cas très courant qui dispose d’une méthode particulière append(). Cette méthode est plus rapide que insert() car la liste réserve automatiquement un espace libre à la fin. A contrario, insert() est plus lente car les opérations qu’elle met en oeuvre sont plus complexes.
>>> l.append(55)
>>> l
[1, 1, 2, 3, 5, 8, 13, 21, 34, 55]
Il existe deux façons d’ajouter des éléments à une liste :
ajouter chaque élément individuellement avec
append()par exemple ;ou ajouter tous les éléments d’une autre liste avec avec
extend().
La deuxième méthode s’appelle la concaténation.
>>> l.extend([89, 144])
>>> l
[1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89, 144]
En Python, la redéfinition d’opérateur est possible comme on l’a vu avec les chaines de caractères. Pour les listes, l’opérateur + a été redéfini pour se comporter (presque) comme extend().
>>> l = [1, 1, 2, 3, 5, 8, 13, 21, 34, 55]
>>> l = l + [89, 144]
>>> l
[1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89, 144]
A expérimenter…
Ci dessus il est dit que l’opérateur + a été redéfini pour se comporter (presque) comme extend(). Observer attentivement ce que retournent les opérations ci dessous, effectuées après la création de la liste.
>>> l.extend([89, 144])
>>> l + [89, 144]
Conclusion ?
Utilisation des slices
L’utilisation des slices est une méthode puissante de modification de liste.
La syntaxe s[i:j] = t où s et t sont des séquences insère la séquence t dans la portion de liste définie par s[i:j]. La taille des deux séquences peut différer.
On peut s’en servir pour l’insertion, la suppression et la modification d’éléments dans une liste.
>>> # insertion
>>> l = [0, 1, 1, 2, 3, 5, 8, 13, 21, 34]
>>> l[2:2] = [0, 0, 0]
>>> l
[0, 1, 0, 0, 0, 1, 2, 3, 5, 8, 13, 21, 34]
>>> # suppression
>>> l[2:5] = []
>>> l
[0, 1, 5, 8, 13, 21, 34]
>>> # modification
>>> l[6:] = [6, 7, 8, 9]
>>> l
[0, 1, 1, 2, 3, 5, 6, 7, 8, 9]
Appartenance
Comme chaque sequence, la chaine de caractères et celles que l’on va aborder par la suite, la list dispose d’un mécanisme simple pour tester l’appartenance ou non d’un élément avec l’opérateur in.
>>> 34 in l
True
>>> 63 in l
False
Itérer sur une liste
L’opérateur in est également utilisé pour l’itération.
>>> l = [0, 1, 1, 2, 3, 5, 8, 13, 21, 34]
>>> for elt in l:
...     print(elt)
...
1
1
2
3
5
8
13
21
34
Il est important de comprendre qu’en Python on itère par défaut sur les éléments de la liste, pas sur les index.
❌ Le code ci dessous produit le même résultat que le code ci dessus, mais est moins concis, donc susceptible de produire plus d’erreurs et plus difficile à comprendre et à maintenir. Il est donc à éviter.
>>> for i in range(len(l)):
...     print(l[i])
...
0
1
1
2
3
5
8
13
21
34
Si l’index est requis, la fonction enumerate() est utilisée.
>>> for i, elt in enumerate(l):
...     print(i, elt)
...
0 0
1 1
2 1
3 2
4 3
5 5
6 8
7 13
8 21
9 34
Autres méthodes
Python dispose de nombreuses méthodes de séquences pour manipuler les séquences dont les listes font partie.
On peut par exemple effectuer une recherche avec index() ou inverser la list avec reverse().
>>> l.index(89)
10
>>> l.reverse()
>>> l
[144, 89, 55, 34, 21, 13, 8, 5, 3, 2, 1, 1]
Listes numériques
Dans le cas particulier où la liste manipulée est uniquement composée de nombres, Python dispose en standard de fonctions permettant de rechercher les valeurs min() et max().
>>> min(l)
1
>>> max(l)
144
Ces fonctions sont dites vectorisées car l’argument est un vecteur de données. Le parcours des données, pour en rechercher le minimum ou le maximum, se fait de façon optimisée dans les fonctions min() et max().
Il est dans la très grande majorité des cas inutile de réécrire sa propre fonction pour réaliser les opérations courantes. Python dispose de très nombreuses fonctions mathématiques, en standard ou dans un module (qu’il convient alors d’importer). Un exemple ci dessous avec les fonctions mean() et median() du module statistics.
>>> from statistics import mean, median
>>> mean(l)
31.333333333333332
>>> median(l)
10.5
Le tri élémentaire
Parmi toutes les méthodes de liste, la méthode sort() permet de trier la liste sur place.
>>> l
[7, 6, 9, 2, 4, 5, 8, 3, 1, 0]
>>> l.sort()
>>> l
[0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
Le paramètre reverse permet de changer l’ordre de tri.
>>> l.sort(reverse=True)
>>> l
[9, 8, 7, 6, 5, 4, 3, 2, 1, 0]
L’algorithme utilisé est le Timsort, dérivé du merge sort et insertion sort.
Listes de listes
Une list peut contenir n’importe quel objet Python et en particulier d’autres listes. On parle alors de listes de listes. C’est une structure très pratique pour représenter des matrices ou des tableaux multidimensionnels.
>>> even = [0, 2, 4, 6, 8]
>>> odd = [1, 3, 5, 7, 9]
>>> fib = [1, 1, 2, 3, 5]
>>> primes = [2, 3, 5, 7, 11]

>>> nums = [even, odd, fib, primes]
>>> type(nums)
<class 'list'>
>>> nums
[[0, 2, 4, 6, 8], [1, 3, 5, 7, 9], [1, 1, 2, 3, 5], [2, 3, 5, 7, 11]]
Les éléments de la liste nums sont eux même des listes. Et donc, nums[1] est aussi une list.
>>> type(nums[1])
<class 'list'>
>>> nums[1]
[1, 3, 5, 7, 9]
>>> type(nums[1][3])
<class 'int'>
>>> nums[1][3]
7
Unpacking
Le list unpacking consiste à décomposer une liste (ou une autre séquence) en plusieurs variables, en une seule instruction. C’est une manière pratique d’extraire des éléments sans devoir utiliser des index.
Unpacking simple
Le nombre d’éléments à gauche du signe égal (LHS) correspond au nombre d’éléments de la liste.
>>> a, b, c = [10, 20, 30]
Ici :
a reçoit 10
b reçoit 20
c reçoit 30
C’est équivalent aux instructions.
>>> a = 10
>>> b = 20
>>> c = 30
Unpacking avec trop peu ou trop d’éléments
Les deux côtés du signe égal doivent contenir exactement le même nombre d’éléments.
>>> a, b = [1, 2, 3]   # ❌ Erreur : trop d'éléments
>>> a, b, c = [1, 2]   # ❌ Erreur : trop peu d'éléments
Gérer des tailles variables
Python fournit un outil très pratique : l’opérateur *, qui permet de capturer plusieurs éléments dans une seule variable.
>>> head, *tail = [1, 2, 3, 4]
>>> head
1
>>> tail
[2, 3, 4]
L’opérateur * peut être en début, au milieu ou à la fin. Au début, il capture le dernier élément d’abord et capture ensuite une séquence de longueur variable.
>>> *start, last = [1, 2, 3, 4]
>>> start
[1, 2, 3]
>>> last
4
Lorsque l’opérateur * est au milieu, il capture le premier et le dernier élément puis la séquence de longueur variable.
>>> first, *middle, last = [1, 2, 3, 4, 5]
>>> first
1
>>> middle
[2, 3, 4]
>>> last
5
Lorsque l’opérateur * est seul.
>>> *a, = [1, 2, 3]
>>> a
[1, 2, 3]
Quand utiliser le list unpacking ?
Voilà quelques raisons d’utiliser le list unpacking :
extraire facilement les premiers ou derniers éléments d’une liste ;
écrire du code plus lisible ;
parcourir des structures récursives ;
décomposer des tuples retournés par des fonctions.
Les list comprehension
On peut construire une list à partir d’une boucle for et de la méthode append().
>>> cubes = []
>>> for i in range(10):
    ...:     cubes.append(i**3)
    ...:

>>> cubes
[0, 1, 8, 27, 64, 125, 216, 343, 512, 729]
Cependant Python possède une syntaxe plus concise et plus élégante, les list comprehension.
>>> cubes = [ i**3 for i in range(10)]
>>> cubes
[0, 1, 8, 27, 64, 125, 216, 343, 512, 729]
La variable utilisée à l’intérieur de la list comprehension est locale à celle ci.
>>> i = 99
>>> [ i**3 for i in range(10)]
[0, 1, 8, 27, 64, 125, 216, 343, 512, 729]
>>> i
99
Il est possible d’ajouter un prédicat ou d’imbriquer des boucles, qui sont exécutées dans l’ordre d’apparition dans la list comprehension ou bien encore de construire des listes de listes.
>>> [ i**3 for i in range(10) if i%2 == 0]
[0, 8, 64, 216, 512]
>>> [i+str(j) for i in 'ab' for j in range(3)]
['a0', 'a1', 'a2', 'b0', 'b1', 'b2']
>>> [[i+str(j) for i in 'abcdefgh'] for j in range(1, 9)]
[['a1', 'b1', 'c1', 'd1', 'e1', 'f1', 'g1', 'h1'],
 ['a2', 'b2', 'c2', 'd2', 'e2', 'f2', 'g2', 'h2'],
 ['a3', 'b3', 'c3', 'd3', 'e3', 'f3', 'g3', 'h3'],
 ['a4', 'b4', 'c4', 'd4', 'e4', 'f4', 'g4', 'h4'],
 ['a5', 'b5', 'c5', 'd5', 'e5', 'f5', 'g5', 'h5'],
 ['a6', 'b6', 'c6', 'd6', 'e6', 'f6', 'g6', 'h6'],
 ['a7', 'b7', 'c7', 'd7', 'e7', 'f7', 'g7', 'h7'],
 ['a8', 'b8', 'c8', 'd8', 'e8', 'f8', 'g8', 'h8']]
On peut également utiliser une clause else dans le prédicat. Dans ce cas, le test est placé avant for.
>>> marks = [8, 12, 7, 15, 16, 13, 4, 14, 9, 15]
>>> [ 'pass' if x >=10 else 'failed' for x in marks]
['failed', 'pass', 'failed', 'pass', 'pass', 'pass', 'failed', 'pass', 'failed', 'pass']
Chaque fois que ce sera possible cette syntaxe devra être utilisée.
Copies et références
Lorsqu’on affecte un objet à un nom de variable (une référence), Python crée une relation entre les deux. On dit que la référence « pointe » vers l’objet et on retrouve ici la notion de pointeurs en C.
Ici la référence l1 pointe vers la liste [0, 1, 2, 3, 4]. L’instruction l2 = l1 duplique la référence vers la liste [0, 1, 2, 3, 4], mais pas la liste elle même ! Pour s’en convaincre:
.. code-block:: python
>>> l1 = [0, 1, 2, 3, 4]
>>> id(l1)
39850888
>>> l2 = l1
>>> id(l2)
39850888
l1 et l2 pointent bien vers le même objet. Ce comportement peut avoir des conséquences inattendues, s’il n’est pas bien compris. En particulier modifier l1 a pour conséquence de modifier l2.
>>> l1.append(5)
>>> l1
[0, 1, 2, 3, 4, 5]
>>> l2
[0, 1, 2, 3, 4, 5]
Pour dupliquer, la liste, plutôt que la référence, il faut forcer la création d’un nouvel objet.
>>> l3 = l1[:] # ou l3 = list(l1)
>>> l3
[0, 1, 2, 3, 4, 5]
>>> l1.append(6)
>>> l1
[0, 1, 2, 3, 4, 5, 6]
>>> l3
[0, 1, 2, 3, 4, 5]
Lorsque la liste est une structure complexe (contenant d’autres objets), il est plus sûr de faire appel à deepcopy().
>>> from copy import deepcopy
>>> a = [[1,2],[3],[4]]
>>> id(a)
1471379026944
>>> b = deepcopy(a)
>>> id(b)
1471379028736
Ce qu’il faut retenir
Une liste se délimite avec
[et]Une liste se délimite avec
(et)Une liste se délimite avec
{et}Une liste peut contenir des objets hétérogènes
Une liste est une collection ordonnée
Les opérations de slicing sur une liste sont légèrement différentes des opérations de slicing sur une chaine de caractères
Une liste est mutable
Une fois créée, la taille d’une liste est figée
est une méthode permettant d’insérer un élément n’importe où dans la liste
est une méthode permettant d’insérer un élément à la fin de la liste
est une méthode permettant de supprimer un élément de la liste sans le retourner
est une méthode permettant de supprimer un élément de la liste en le retournant
appendest une méthode qui permet d’ajouter plusieurs éléments à la liste en une seule opérationextendest une méthode qui permet d’ajouter un seul élément à la liste en une seule opérationLe slicing peut être utilisé pour extraire des éléments d’une liste
Le slicing peut être utilisé pour insérer des éléments dans une liste
Le slicing ne peut pas modifier la taille d’une liste
Sur une liste, l’opérateur d’appartenance
infonctionne comme pour une chaine de caractèresLa façon privilégiée de parcourir une liste est d’itérer sur ses éléments
La façon privilégiée de parcourir une liste est d’itérer sur l’index de ses éléments
Une liste dispose d’une méthode pour trier ses éléments
Une liste peut contenir n’importe quel objet Python
On peut construire des listes imbriquées
Une est une façon concise de construire une liste
Une list comprehension ne contient pas de structure conditionnelle
Une list comprehension peut construire une liste unidimensionnelle
Une list comprehension doit construire une liste unidimensionnelle
Il est nécessaire que VS Code soit démarré sur la machine hôte, pointe vers le répertoire e3-programmation-labs-student et que le container Docker soit lancé.
Le répertoire concerné est lab_python_syracuse. Lisez attentivement le fichier README.md pour comprendre la consigne. Il est efficace d’y accéder depuis le dépôt distant pour profiter du formatage.
Une fois l’exercice terminé, effectuer une revue de code, ajouter la documentation, et s’assurer que les repos local et distant soient correctement synchronisés.
Les tuples
Une vidéo de présentation des tuples…
Contrairement à la list, le tuple est une séquence immutable. Comme la liste, c’est une collection ordonnée. Il est défini par les opérateurs ( et ). Bien que le langage le permette, il n’est pas conseillé d’utiliser une liste pour stocker des collections hétérogènes. Cet usage est plutôt réservé au tuple.
>>> ev = ('Everest', 8848, 'Asie', 'Himalaya')
>>> type(ev)
<class 'tuple'>
>>> len(ev)
4
Slicing
Le tuple étant une sequence, il dispose des mêmes opérations que la list, à l’exception des opérations de modification puisque le tuple est immutable.
>>> # indexation
>>> ev[0]
'Everest'
>>> ev[1]
8848
>>> # slicing
>>> ev[:2]
('Everest', 8848)
Le tuple est immutable
Le tuple est immutable et toute opération tentant à le modifier déclenche une erreur.
>>> # modification d'un élément
>>> ev[1] = 8849
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: 'tuple' object does not support item assignment
>>> # suppression d'un élément
>>> del(ev[2])
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: 'tuple' object doesn't support item deletion
L’opération d’indexation d’un tuple ne peut apparaître qu’à droite (RHS) de l’opérateur d’affectation =.
Appartenance
Le tuple dispose de toutes les méthodes de sequence. On peut en particulier utiliser l’opérateur in pour tester l’appartenance.
>>> 'Everest' in ev
True
>>> 'Kilimandjaro' in ev
False
Itérer sur un tuple
Comme la list, le tuple est une séquence et l’opérateur in est utilisé pour l’itération.
>>> for elt in ev:
...     print(elt)
...
Everest
8848
Asie
Himalaya
Les méthodes de tuple
Le tuple étant une séquence immutable, les interactions possibles avec celui ci sont limitées.
A expérimenter…
Même si le nombre de méthodes d’un tuple est limité, il en existe cependant deux. Trouvez les, de deux façons différentes:
en utilisant une fonction Python dans l’interpréteur interactif ;
en recherchant dans la documentation officielle.
Listes de tuples
Comme on l’a vu précédemment, la list peut contenir tout type de donnée, et en particulier on peut construire une liste de tuple.
>>> ac = ('Aconcagua', 6959, 'Amérique du Sud', 'Cordillère des Andes')
>>> mc = ('McKinley', 6190, 'Amérique du Nord', 'Alaska')
>>> ki = ('Kilimandjaro', 5892, 'Afrique', 'Vallée du Grand Rift')
>>> sommets = [ev, ac, mc, ki]

>>> sommets
[('Everest', 8848, 'Asie', 'Himalaya'),
 ('Aconcagua', 6959, 'Amérique du Sud', 'Cordillère des Andes'),
 ('McKinley', 6190, 'Amérique du Nord', 'Alaska'),
 ('Kilimandjaro', 5892, 'Afrique', 'Vallée du Grand Rift')]
>>> # indexation en profondeur
>>> sommets[2][3]
'Alaska'
Les tuples nommés
Le tuple est parfaitement adapté à la création d’une structure de données complexe, à l’image des structures du langage C. Cependant l’accès à chacun des champs à partir de l’index (comme on vient de le voir) n’est pas très commode. Le module collections dispose d’un namedtuple() autorisant un accès facilité aux éléments.
>>> from collections import namedtuple
>>> Sommet = namedtuple('Sommet', ['nom', 'alt', 'pays', 'chaine'])
>>> ev = Sommet('Everest', 8848, 'Asie', 'Himalaya')
>>> ev
Sommet(nom='Everest', alt=8848, pays='Asie', chaine='Himalaya')

>>> ev.nom
'Everest'
>>> ev.chaine
'Himalaya'
Ce qu’il faut retenir
Un tuple se délimite avec
[et]Un tuple se délimite avec
(et)Un tuple se délimite avec
{et}Un tuple peut contenir des objets hétérogènes
Un tuple est une collection ordonnée
Les opérations de slicing sur un tuple sont légèrement différentes des opérations de slicing sur une chaine de caractères
Un tuple est mutable
Une fois créé, la taille d’un tuple est figée
On peut insérer un élément dans un tuple après sa création
On peut supprimer un élément d’un tuple
Un tuple dispose de méthodes
Le slicing peut être utilisé pour extraire des éléments d’un tuple
Le slicing peut être utilisé pour insérer des éléments dans un tuple
Le slicing ne peut pas modifier la taille d’un tuple
Sur un tuple, l’opérateur d’appartenance
infonctionne exactement comme pour une listeLa façon privilégiée de parcourir un tuple est d’itérer sur ses éléments
La façon privilégiée de parcourir un tuple est d’itérer sur l’index de ses éléments
Un tuple dispose d’une méthode pour trier ses éléments
On peut construire un tuple dont les éléments sont triés
Un tuple peut contenir n’importe quel objet Python
On peut construire des tuples imbriqués
Il est nécessaire que VS Code soit démarré sur la machine hôte, pointe vers le répertoire e3-programmation-labs-student et que le container Docker soit lancé.
Le répertoire concerné est lab_python_asciiart. Lisez attentivement le fichier README.md pour comprendre la consigne. Il est efficace d’y accéder depuis le dépôt distant pour profiter du formatage.
Une fois l’exercice terminé, effectuer une revue de code, ajouter la documentation, et s’assurer que les repos local et distant soient correctement synchronisés.
Les sets
Une vidéo de présentation des ensembles…
Les set sont des containers mutables non ordonnés qui possèdent les caractéristiques des ensembles mathématiques. En particulier, ils ne disposent pas d’éléments dupliqués. Ils se définissent à partir des opérateurs { et } ou du constructeur set.L’ordonnancement n’a pas de sens pour un set et n’est pas prédictible. L’implémentation de l’algorithme de hachage utilisé pour stocker les éléments dans le set est optimisée pour la rapidité d’accès aux éléments, mais ne garantit pas un ordre particulier.
>>> foot = set(['Angers', 'Bordeaux', 'Brest', 'Dijon', 'Lens', 'Lille', 'Lorient', 'Lyon', 'Marseille', 'Metz', 'Monaco', 'Montpellier', 'Nantes', 'Nice', 'Nimes', 'Paris', 'Reims', 'Rennes', 'Saint - Étienne', 'Strasbourg'])
>>> len(foot)
20
>>> foot
{'Marseille', 'Lille', 'Metz', 'Rennes', 'Nice', 'Nantes', 'Nimes', 'Strasbourg', 'Bordeaux', 'Dijon', 'Montpellier', 'Brest', 'Lorient', 'Reims', 'Lens', 'Paris', 'Monaco', 'Angers', 'Lyon', 'Saint - Étienne'}
Comme la list, le set est une séquence mutable. Il dispose donc de toutes les méthodes correspondantes à ce type de séquence. On peut donc en particulier le modifier une fois créé, par exemple retirer des éléments avec la méthode remove() ou en ajouter avec la méthode add()
>>> foot.remove('Metz')
>>> len(foot)
19
>>> foot.add('Metz')
>>> len(foot)
20
Note
La sémantique est importante :
Le constructeur set prend en argument une séquence (une list pour ce qui concerne l’exemple ci dessus). Cette séquence peut éventuellement contenir des éléments dupliqués. Les doublons sont automatiquement éliminés.
A expérimenter…
Une chaîne de caractères (str) est une séquence et peut être utilisée pour construire un set. Conjecturer le résultat de l’opération suivante.
>>> f = set('football')
Vérifier dans un interpréteur interactif.
Le set est un conteneur non ordonné. La position ou l’ordre d’insertion des éléments n’est pas prédictible. En conséquence, les opérations d’indexation ou de slicing ne sont pas supportées.
>>> f[0]
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: 'set' object does not support indexing
Les set ne peuvent contenir que des objets immutables, dont la structure ne peut pas être modifiée après création. Ces objets sont dits « hashables ». Les exemples ci dessus utilisent des chaînes de caractères. On peut également créer des set de nombres entiers mais si l’on tente d’insérer un objet mutable dans un set, une exception de type TypeError est générée.
>>> s = {0, 1, 2, 3, 4}
>>> s
{0, 1, 2, 3, 4}
>>> s = {0, 1, 2, [3, 4]}
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: unhashable type: 'list'
Appartenance
Comme toutes les séquences, les set disposent de l’opérateur in.
>>>  basket = set(['Boulazac', 'Bourg-en-Bresse', 'Chalon/Saône', 'Cholet', 'Reims', 'Dijon', 'Gravelines', 'Levallois', 'Le Mans', 'Le Portel', 'Limoges', 'Monaco', 'Nanterre', 'Orléans', 'Pau', 'Roanne', 'Strasbourg', 'Villeurbane'])
>>>  'Limoges' in basket
True
>>>  'Limoges' in foot
False
Itérer sur un set
Le set étant également une séquence, l’opérateur in est utilisé pour l’itération.
>>> for elt in f:
...     print(elt)
...
a
b
o
f
t
l
Puisque le set ne supporte pas l’indexation, on ne peut itérer que sur les éléments. Inutile donc ici de préciser une bonne pratique, contrairement aux str, list et tuple.
Opérations ensemblistes
Les set disposent d’opérations ensemblistes puissantes et rapides :
intersection
union
différence
inclusion
etc…
La méthode intersection() est utilisée pour calculer l’intersection de deux ou plusieurs set. L’opérateur & permet une écriture plus lisible. La méthode union() est utilisée pour calculer l’union de deux ou plusieurs set. L’opérateur | permet une écriture plus lisible.
>>>  rugby = set(['Agen', 'Bayonne', 'Bordeaux', 'Brive', 'Castres', 'Clermont', 'La Rochelle', 'Lyon', 'Montpellier', 'Pau', 'Racing 92','Paris', 'Toulon', 'Toulouse'])
>>> foot & rugby # intersection
{'Paris', 'Montpellier', 'Bordeaux', 'Lyon'}
>>> foot | rugby # union
{'Marseille', 'Monaco', 'Lille', 'Metz', 'Dijon', 'Pau', 'Agen', 'Clermont', 'Montpellier', 'Racing 92', 'Rennes', 'Bayonne', 'Brive', 'Nice', 'Nantes', 'Brest', 'Toulouse', 'Lorient', 'Castres', 'Nimes', 'La Rochelle', 'Reims', 'Lens', 'Paris', 'Toulon', 'Strasbourg', 'Angers', 'Lyon', 'Saint - Étienne', 'Bordeaux'}
La méthode difference() est utilisée pour calculer la différence de deux ou plusieurs set. L’opérateur - permet une écriture plus lisible. La méthode symetric_difference() est utilisée pour calculer la différence symétrique (des éléments appartenant à l’un ou à l’autre mais pas aux deux) de deux set. L’opérateur ^ permet une écriture plus lisible.
>>> rugby - foot - basket # difference
{'Toulouse', 'Castres', 'Agen', 'Clermont', 'La Rochelle', 'Racing 92', 'Toulon', 'Bayonne', 'Brive'}
>>> rugby ^ foot
{'Marseille', 'Monaco', 'Lille', 'Metz', 'Dijon', 'Pau', 'Agen', 'Clermont', 'Racing 92', 'Rennes', 'Bayonne', 'Brive', 'Nice', 'Nantes', 'Brest', 'Toulouse', 'Lorient', 'Castres', 'Nimes', 'La Rochelle', 'Reims', 'Lens', 'Toulon', 'Strasbourg', 'Angers', 'Saint - Étienne'}
Pour une meilleure compréhension de la manipulation des set, on consultera les méthodes de set dédiées.
Les set comprehension
Comme pour Les listes, on peut construire un set de façon concise avec un set comprehension.
>>> {x*y for x in {1,2,3} for y in {2,3,4} if x != y}
{2, 3, 4, 6, 8, 12}
Chaque fois que ce sera possible cette syntaxe devra être utilisée.
Les frozensets
Il peut être utile de disposer d’un set immutable. C’est le rôle du type frozenset. Il se construit à partir d’une séquence, comme le set. Il ne dispose pas de méthodes pour ajouter ou supprimer des éléments. Il est donc immutable.
Ce qu’il faut retenir
Un set se délimite avec
[et]Un set se délimite avec
(et)Un set se délimite avec
{et}Un set peut contenir des objets hétérogènes
Un set peut contenir des objets mutables
Un set est mutable
Un set est une collection ordonnée
Les opérations de slicing sur un set sont possibles
Une fois créée, la taille d’un set est figée
est une méthode permettant d’insérer un élément dans un set
Il est possible d’insérer un élément à la fin d’un set
est une méthode permettant de supprimer un élément d’un set
Le constructeur d’un set prend en paramètre une séquence
Le slicing peut être utilisé pour extraire des éléments d’un set
Le slicing peut être utilisé pour insérer des éléments dans un set
Sur un set, l’opérateur d’appartenance
infonctionne comme pour toute séquenceOn peut parcourir un set en itérant sur ses éléments
On peut parcourir un set en itérant sur l’index de ses éléments
Un set peut contenir n’importe quel objet Python
On peut construire des sets imbriqués
Un est une façon concise de construire un set
Il est nécessaire que VS Code soit démarré sur la machine hôte, pointe vers le répertoire e3-programmation-labs-student et que le container Docker soit lancé.
Le répertoire concerné est lab_python_langue_francaise. Lisez attentivement le fichier README.md pour comprendre la consigne. Il est efficace d’y accéder depuis le dépôt distant pour profiter du formatage.
Une fois l’exercice terminé, effectuer une revue de code, ajouter la documentation, et s’assurer que les repos local et distant soient correctement synchronisés.
Les dictionnaires
Une vidéo de présentation des dictionnaires…
Comme on l’a vu, Python dispose d’un grand nombre de séquences. Tous les langages modernes disposent également d’un ou plusieurs tableaux associatifs. En Python il prend le nom de dictionnaire. Il se définit à partir des opérateurs { et } ou du constructeur de la classe dict. Le dictionnaire est un container mutable.
Structure
Un dictionnaire est constitué d’un ensemble de paires clé:valeur. La clé doit être un élément immutable. Un dict conserve l’ordre dans lequel les paires clé:valeur ont été insérées.
>>> d = dict()
>>> type(d)
<class 'dict'>
On ajoute des éléments à un dict avec l’opérateur d’indexation [ ].
>>> d['Italy'] = 'Rome'
>>> d['France'] = 'Paris'
>>> d['Spain'] = 'Madrid'
>>> d
{'Italy': 'Rome', 'France': 'Paris', 'Spain': 'Madrid'}
Un dict possède un ensemble de méthodes. La méthode keys() retourne une vue des clés du dictionnaire et la méthode values() retourne une vue des valeurs associées.
>>> dir(d)
[..., 'clear', 'copy', 'fromkeys', 'get', 'items', 'keys', 'pop', 'popitem', 'setdefault', 'update', 'values']
>>> d.keys()
dict_keys(['Italy', 'France', 'Spain'])
>>> d.values()
dict_values(['Rome', 'Paris', 'Madrid'])
Les vues sont des objets itérables.
>>> for key in d.keys():
...     print(key)
...
Italy
France
Spain
On peut également créer un dict à partir d’une sequence de paires clé:valeur. Cette séquence peut être une list de tuple ou un tuple de tuple
>>> d = dict([('Italy','Rome'), ('Spain','Madrid'), ('France','Paris')])
>>> d
{'Spain': 'Madrid', 'Italy': 'Rome', 'France': 'Paris'}
>>> d = dict((('Italy','Rome'), ('Spain','Madrid'), ('France','Paris')))
>>> d
{'Spain': 'Madrid', 'Italy': 'Rome', 'France': 'Paris'}
Accès aux éléments
Si d est un dict, on accède à ses éléments avec la syntaxe d[key]. Si l’élément existe, il est retourné. S’il n’existe pas, une erreur se produit.
>>> d['Italy']
'Rome'
>>> d['Portugal']
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
KeyError: 'Portugal'
get() est une méthode plus sûre. Si l’élément existe, il est retourné. S’il n’existe pas, une valeur par défaut est utilisée. Si elle n’est pas précisée, la valeur par défaut est None.
>>> d.get('Portugal')
>>> d.get('Portugal', 'key not in dict')
'key not in dict'
Modification de la structure d’un dictionnaire
Le dict étant un élément mutable, on peut ajouter des éléments avec la syntaxe d[key] = value. On peut également en retirer avec la syntaxe del d[key]. On peut également utiliser la méthode update() qui prend en argument un second dictionnaire. Le dictionnaire sur lequel la méthode est appelée est modifié avec les paires clé:valeur qu’il contient.
>>> d['Portugal'] = 'Lisbon'
>>> d
{'Portugal': 'Lisbon', 'Italy': 'Rome', 'France': 'Paris', 'Spain': 'Madrid'}
>>> del d['Spain']
>>> d
{'Portugal': 'Lisbon', 'Italy': 'Rome', 'France': 'Paris'}
>>> d.update({'Germany':'Berlin', 'United Kingdom':'London'})
>>> d
{'Italy': 'Rome', 'France': 'Paris', 'Portugal': 'Lisbon', 'Germany': 'Berlin', 'United Kingdom': 'London'}
A expérimenter…
Ajouter quelques paires clé-valeur au dictionnaire ci dessus avec l’opérateur d’indexation [ ]. Puis de façon groupée à partir d’un second dictionnaire.
Itérer sur le dictionnaire ainsi créé en utilisant le Formatage des chaines de caractères pour produire un affichage structuré de l’association capitale-pays.
Appartenance
Comme les sequences le dict utilise l’opérateur in pour tester l’appartenance d’une clé ou d’une valeur. Tester l’appartenance au dictionnaire lui même fonctionne pour les clés mais pas pour les valeurs.
>>> 'Italy' in d.keys()
True
>>> 'Rome' in d.values()
True
>>> 'Italy' in d
True
>>> 'Rome' in d
False
Itérer sur un dictionnaire
La méthode keys() retournant un iterable, on peut utiliser l’opérateur in pour itérer sur les clés.
>>> for k in d.keys():
...     print(k)
...
United Kingdom
Italy
Germany
Portugal
France
On a constaté plus haut que la méthode keys() retourne une vue des clés du dictionnaire. Cette vue est dynamique, c’est à dire qu’elle évolue tout au long de la vie du dictionnaire.
>>> keys = d.keys()
>>> keys
dict_keys(['United Kingdom', 'Italy', 'Germany', 'Portugal', 'France'])
>>> del d['Italy']
>>> keys
dict_keys(['United Kingdom', 'Germany', 'Portugal', 'France'])
Au delà des clés et des valeurs, on peut récupérer la paire clé-valeur dans un tuple en une seule opération avec la méthode items().
>>> for k,v in d.items():
...     print(k,v)
...
United Kingdom London
Germany Berlin
Portugal Lisbon
France Paris
Important
Pour une connaissance approfondie des dictionnaires, on consultera la liste des méthodes associées.
Les “dict comprehension”
Comme pour les list et les set, il existe une syntaxe compacte pour construire un dict : les dict comprehension. L’exemple ci dessous donne le code ASCII des caractères de ponctuation.
>>> import string
>>> { char:ord(char) for char in string.punctuation}
{']': 93, '&': 38, '~': 126, ... , '/': 47}
La sortie a été tronquée pour l’affichage
Implémentation de switch
Python ne dispose pas en standard de l’instruction switch mais une implémentation élégante et compacte est possible avec un dictionnaire.
>>> d = {'a':'Choix A', 'b':'Choix B', 'c':'Choix C'}
>>> choix = 'b'
>>> print(d[choix])
L’intérêt est de grouper les différents cas sur une seule ligne. Comme en Python tout est objet, les valeurs du dictionnaire peuvent être des fonctions.
A titre d’exemple, l’utilisation de switch en Java:
 1public class SwitchDemo {
 2    public static void main(String[] args) {
 3        String choix = 'b';
 4        String res;
 5        switch (choix) {
 6            case 'a':  res = "Choix A";
 7                       break;
 8            case 'b':  res = "Choix B";
 9                       break;
10            case 'c':  res = "Choix C";
11                       break;
12        }
13        System.out.println(res);
14    }
15}
Ce qu’il faut retenir
Un dictionnaire se délimite avec
[et]Un dictionnaire se délimite avec
(et)Un dictionnaire se délimite avec
{et}Les clés d’un dictionnaire sont obligatoirement immutable
Les clés d’un dictionnaire sont toutes de même type
On peut utiliser des chaines de caractères comme clés d’un dictionnaire
On peut utiliser des entiers comme clés d’un dictionnaire
On peut utiliser des tuples comme clés d’un dictionnaire
On peut utiliser des listes comme clés d’un dictionnaire
On peut utiliser des sets comme clés d’un dictionnaire
Les valeurs d’un dictionnaire sont toutes de même type
Les valeurs d’un dictionnaire sont obligatoirement immutable
Un dictionnaire est mutable
Un dictionnaire est une collection ordonnée
Une fois créée, la taille d’un dictionnaire est figée
L’opérateur d’indexation permet d’insérer un élément dans un dictionnaire
L’opérateur d’indexation permet d’insérer un élément au début d’un dictionnaire
L’opérateur d’indexation permet d’insérer un élément à la fin d’un dictionnaire
permet de supprimer un élément d’un dictionnaire
Le constructeur d’un dictionnaire peut prendre en paramètre une séquence
Cette séquence est une séquence de clés
Cette séquence est une séquence de valeurs
Cette séquence est une séquence de paires
clé:valeurLa méthode permet de modifier un dictionnaire avec un autre dictionnaire
Sur un dictionnaire, l’opérateur d’appartenance
infonctionne pour les clésSur un dictionnaire, l’opérateur d’appartenance
infonctionne pour les valeursOn peut parcourir un dictionnaire en itérant sur ses clés
On peut parcourir un dictionnaire en itérant sur ses valeurs
On peut construire des dictionnaires imbriqués
Un est une façon concise de construire un dictionnaire